Taylor Fang

2 種類の読み手を見据えた設計
ドキュメントは、製品とその土台となる仕組みを伝えるものです。ユーザーが製品とその仕組みについてのメンタルモデルを構築するのを助け、直感的な流れに沿って導きながら、その過程で生じる疑問に答えるものでなければなりません。ドキュメントは、新しいユーザーには概念を噛み砕いて示し、習熟するにつれて複雑さを開示していく必要があります。
さらに、新たな読み手も現れています。 エージェントは急速に人間のユーザーと並ぶ主役になりつつあり、ドキュメントを発見し、読み、解析するための専用の設計を必要としています。
私たちのドキュメントは、プラットフォームが新しいフレームワークやインテグレーションに対応していくのに合わせて、自然発生的に拡大してきました。しかし、構成、順序、言葉遣いに次第にばらつきが生じ始めました。
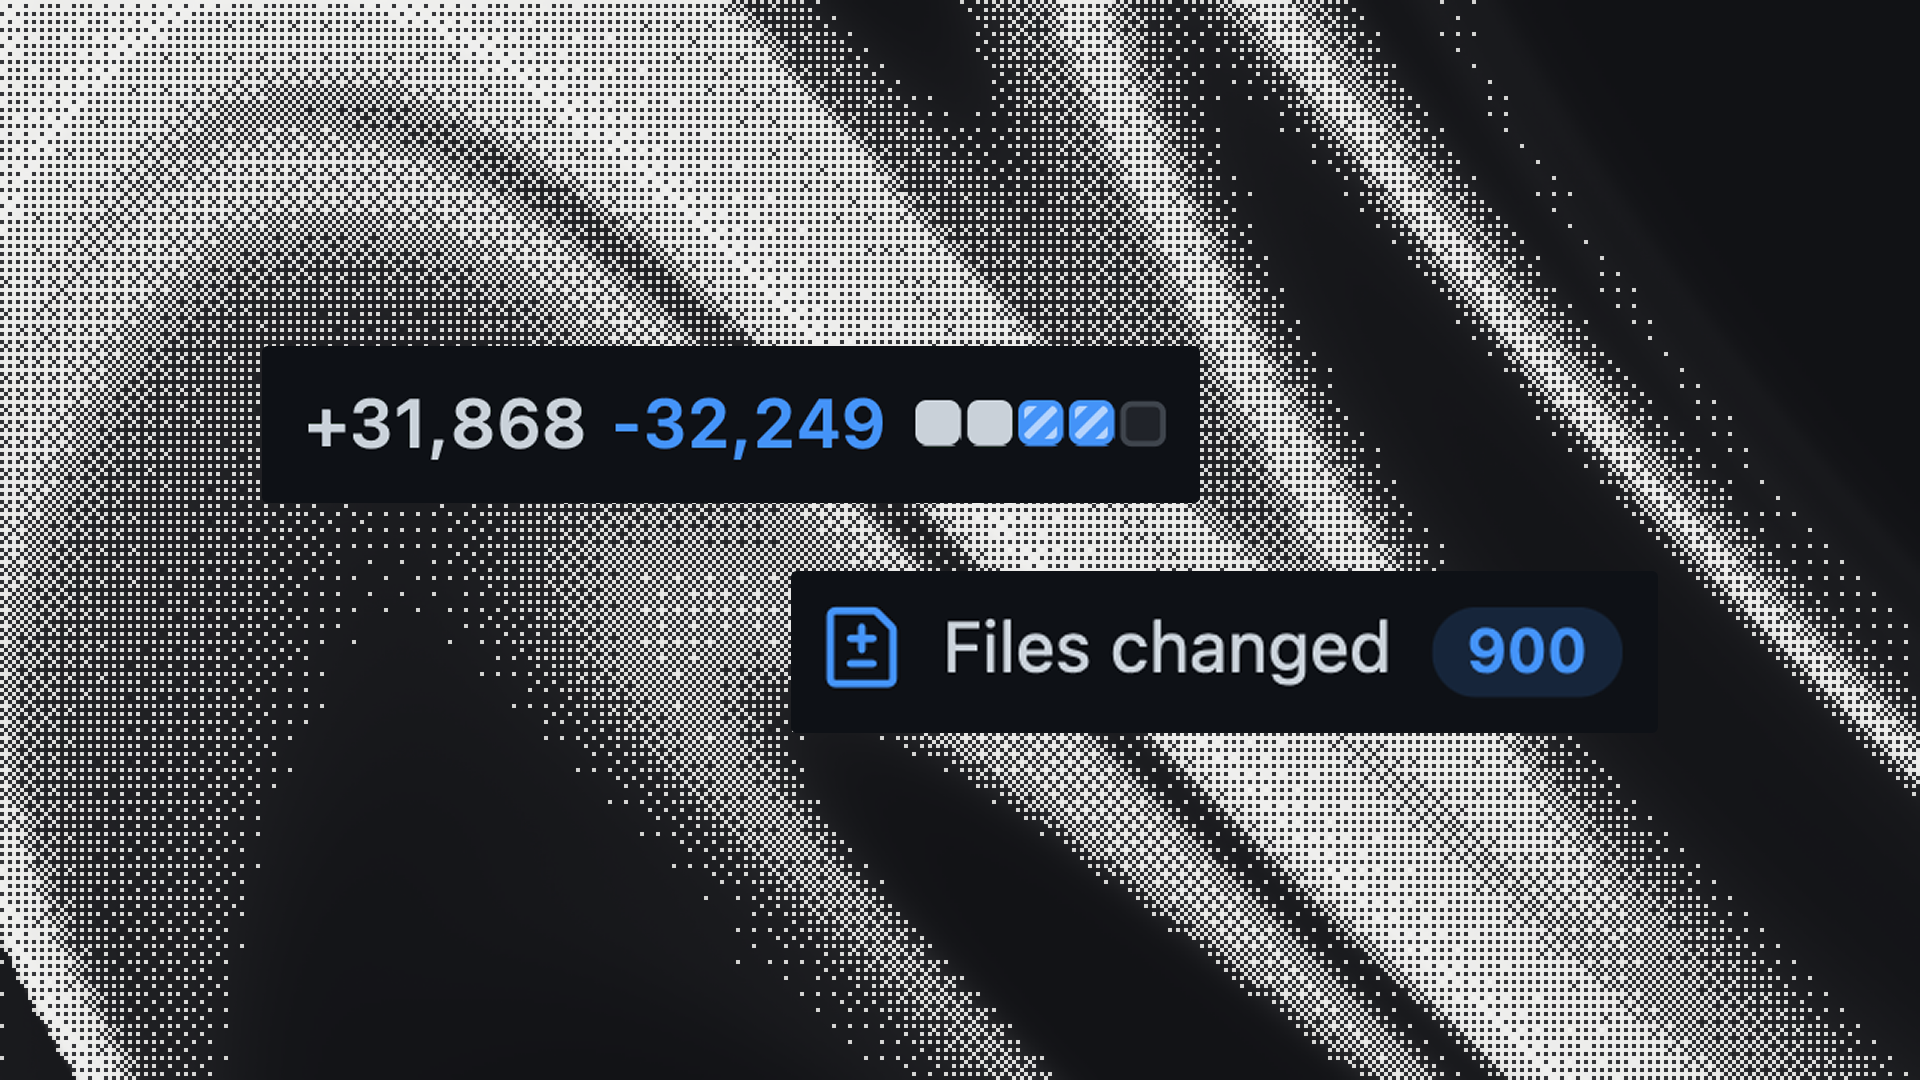
そこで私たちは、人間とエージェントの双方にとっての読み手体験を意識しながら、ドキュメントをゼロから作り直すことにしました。最初のリファクタリングで手を入れたのは 900 ファイル (+31,868 / −32,249 行) です。対象読者、ページ構成、文体と文法に関するルールを定めた 13,000 語のスタイルガイドも作成しました。現在、ドキュメントはスタイルガイドに対して lint を実行する日次のクラウドエージェントによって保守されています。
エージェントが読み取りやすいよう、サイトをインデックスする llms.txt と llms-full.txt も提供しており、URL に .md を付けることでどのドキュメントページも raw な Markdown として取得できます。また、コーディング エージェント向けのドキュメントページを用意し、エージェントにセットアップ方法、使い方、正しい翻訳方法を伝える drop-in の AGENTS.md を、MCP サーバーおよび machine-readable な OpenAPI 仕様とあわせて提供しています。
この Post では、私たちが行った変更と、そこから得た学びを紹介します。
インスピレーション
私たちは、ベストプラクティスや「これはいい」と思う開発者向けドキュメントを調査し、そこからインスピレーションを得ました。
- Lee Robinson のドキュメント論。「初めての体験はシンプルに保ち、複雑さは少しずつ明かしていく」。彼が挙げる10の原則は、高速であること、読みやすいこと、AIネイティブであること、洗練されていること、レスポンシブであること。そしてもちろん、ローカライズされていることです。 (実際、私たちは Lee と一緒に Cursor のドキュメントをローカライズしました!)
- Fuma Nama のドキュメント論。彼はシンプルな文体を勧め、太字、見出し、ハイパーリンク、リスト、表を使ってより論理的な構造を組み立てることを推奨しています。さらに Fuma は、読者体験においてナビゲーションはコンテンツ以上に重要になり得るとも述べています。 (Fuma の考え方については、インタビュー記事で詳しく読むことができます。)
- Devin Logan のエージェント対応ドキュメント論。Devin は、ユーザーがエージェント経由でドキュメントにアクセスすることが新たな前提になっていると指摘します。そのうえで、AI にとっての読みやすさを実現する手順を示しています。コンテンツ面では、システムを説明し、実行可能な手順を提示すること。プラットフォーム面では、ページがエージェントから見つけやすく、余計な要素をそぎ落とした形になっていることです。
- 私たちが気に入っている開発者向けドキュメントも細かく見ていきました。明快さとシンプルさの Linear、分かりやすい階層ナビゲーションの Replicate、美しいデザインの shadcn/ui、開発者に寄り添った言葉遣いとコミュニティ機能の Next.js、心地よいビジュアルの Convex、埋め込み機能の Stripe など、数多くのドキュメントです。
ユーザージャーニー
技術的な機能を淡々と説明するのではなく、ユーザーが何を達成したいのかを軸にページと文言を再構成しました。すべてのセクションは、Quickstart、Guides、Reference という一貫した骨格に沿っています。
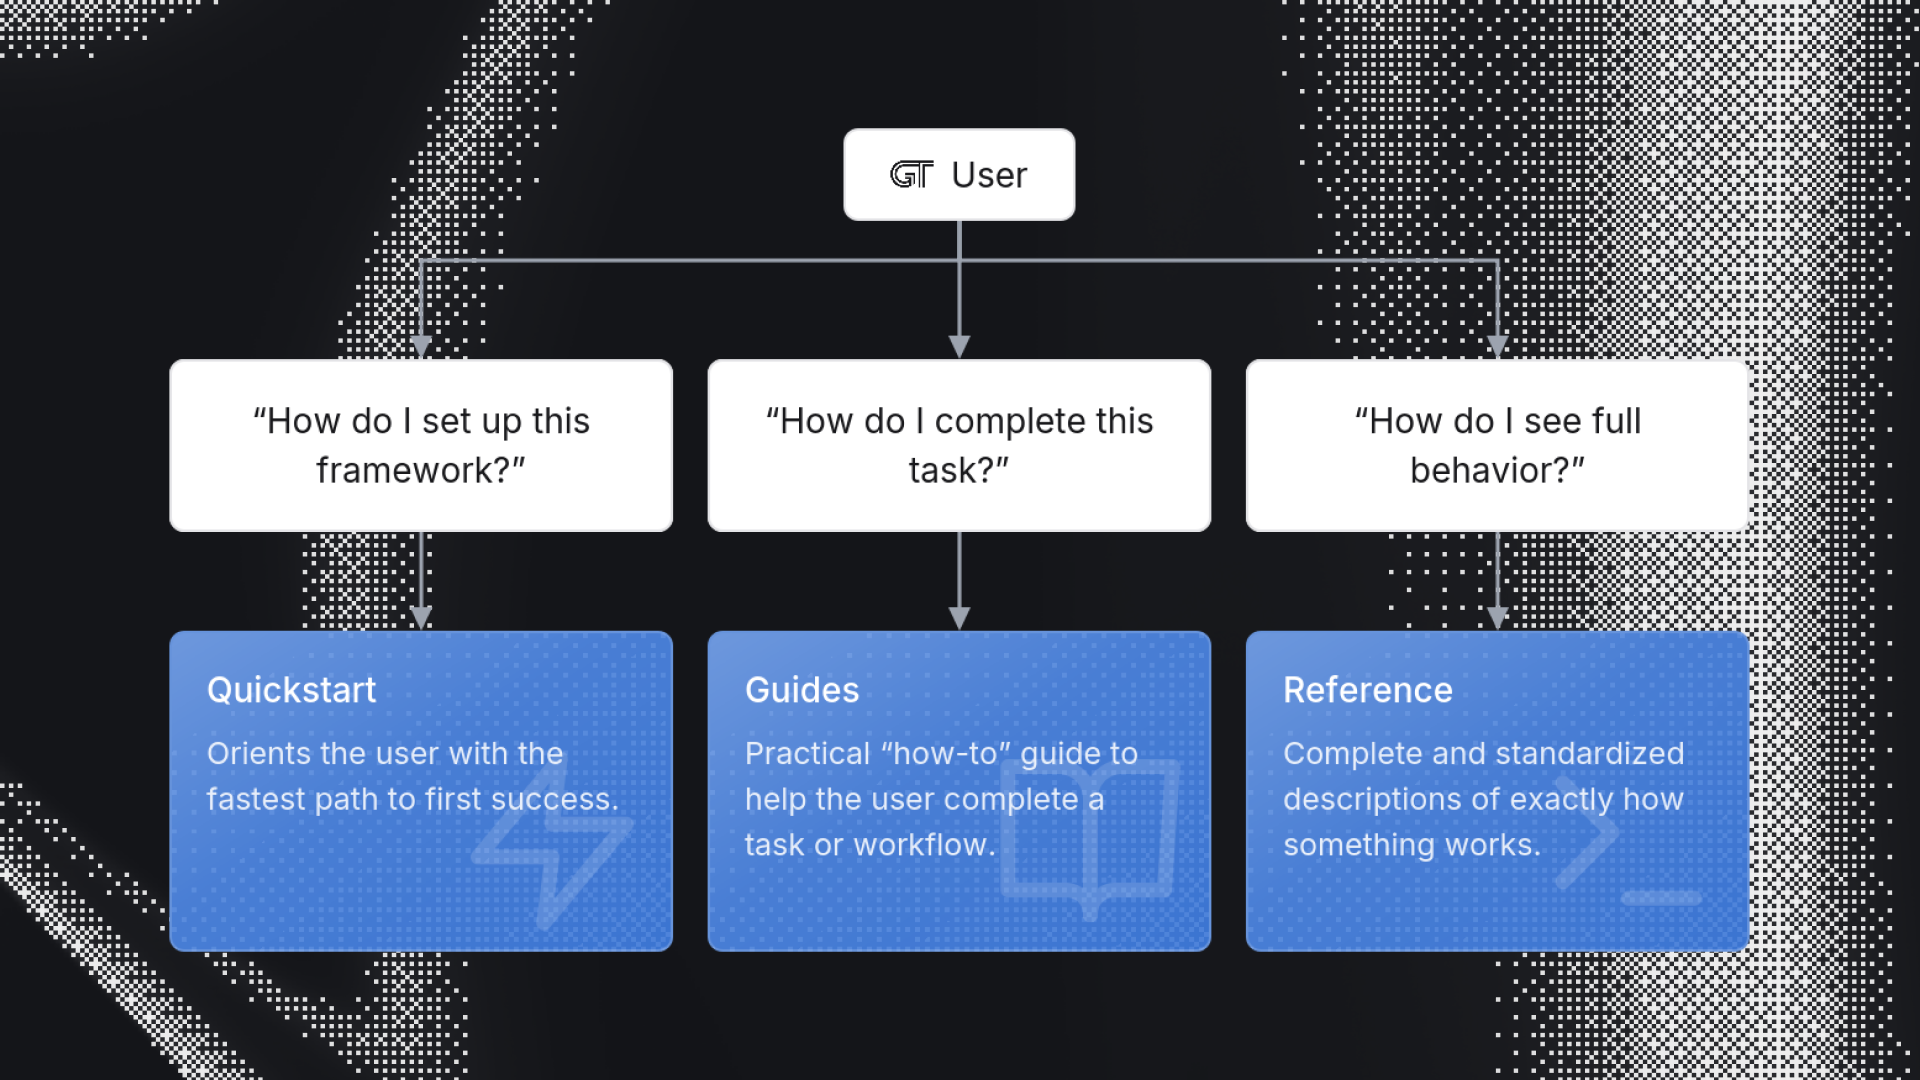
Guides のタイトルは動名詞、つまりユーザーが片付けたい仕事として表現しています。たとえば「Reviewing and editing translations」や「Handling plurals and branches」といった具合です。ある workflow を完了させたい新規ユーザーは、どの reference 用語で検索すればよいか悩む必要がなく、自分が取りたい操作をそのまま検索できます。
うれしい副次効果として、ドキュメントの Guides 自体が SEO で上位に表示されるようになりました。「React managing locales」「React translating jsx」「Configuring a Vite SPA i18n」「React plurals and branches」「Translating rrweb」など、多くの検索で Google の最上位に表示されています。
ドキュメントサイト自体は Fumadocs 上に構築されています。先日、その作者に、美しくコンポーザブルな reader experience についての考え方をインタビューしました。
論理的で直感的な導線
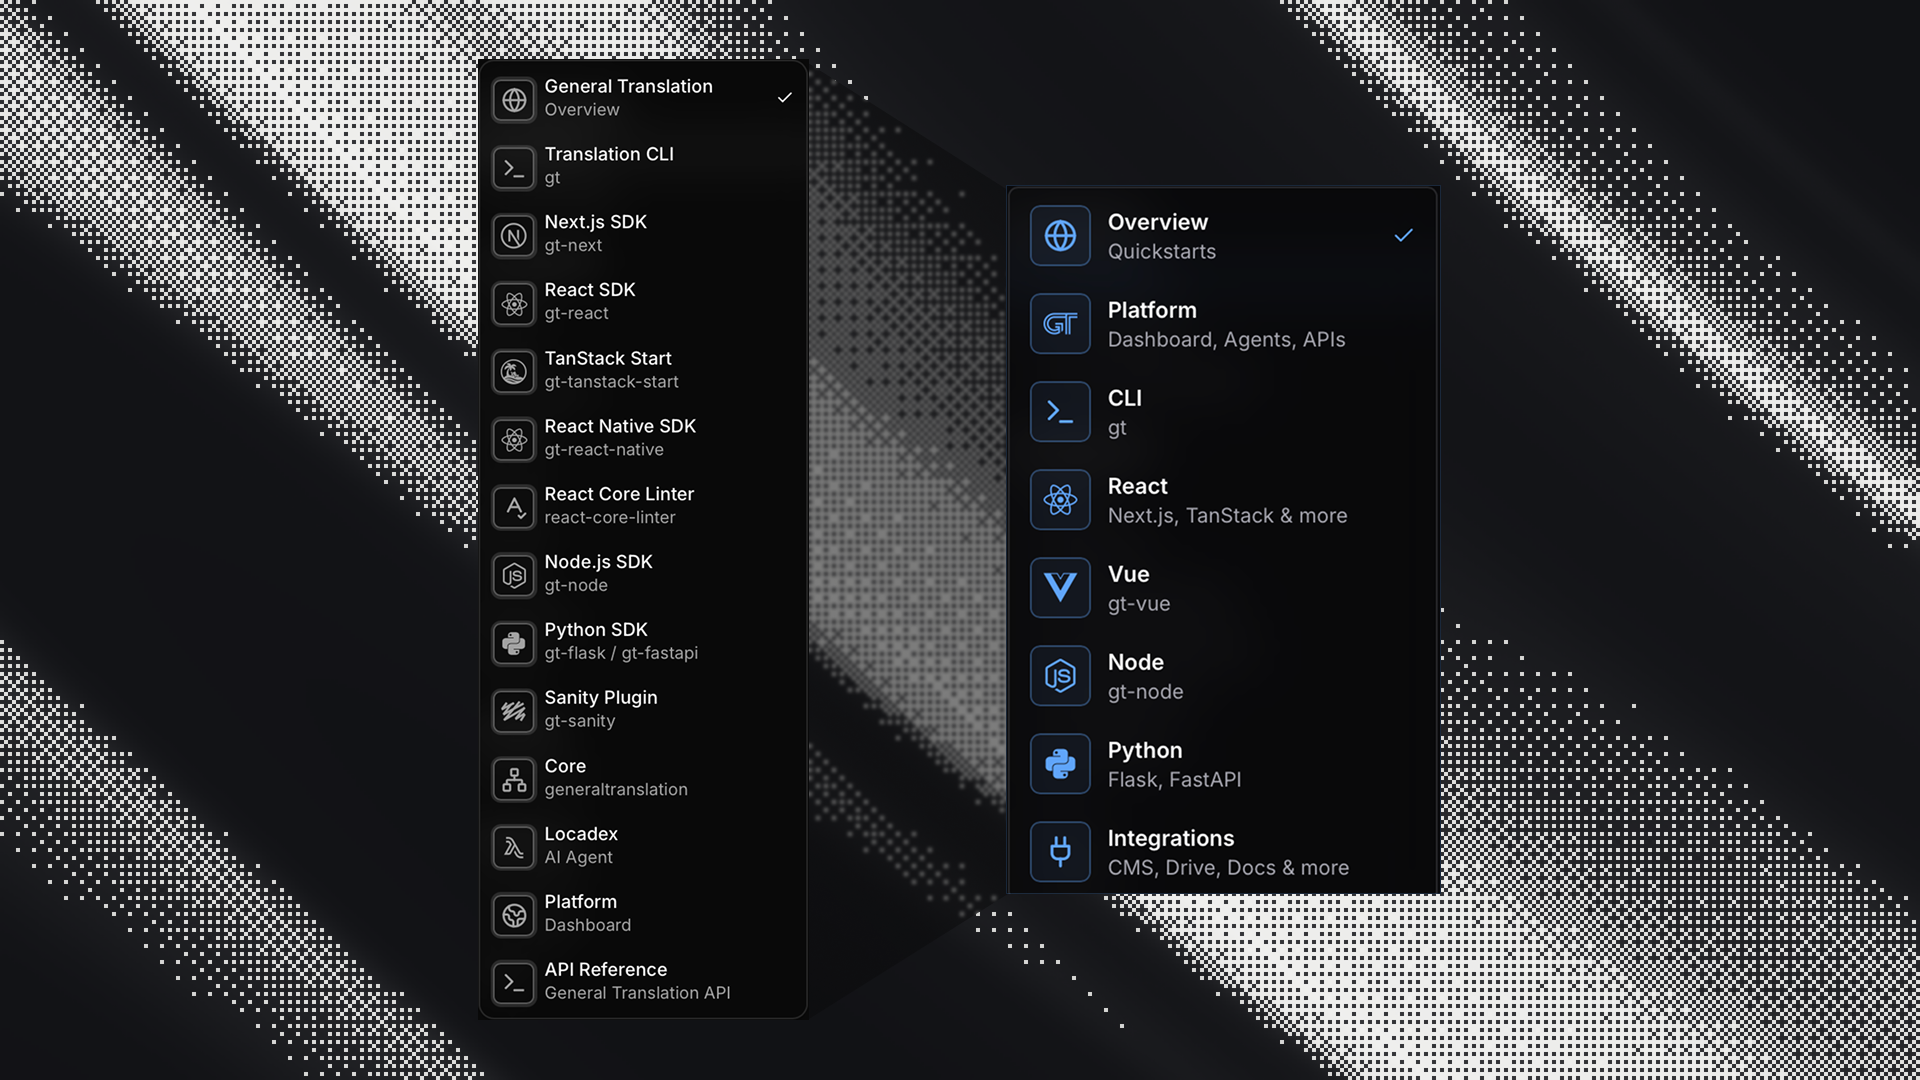
ドキュメントは、ユーザーが製品とその仕組みについてのメンタルモデルを築く手助けとなるべきものです。そのためには、ナビゲーションと各ページの両方で直感的な導線が欠かせません。並び順は意図的かつ意味のあるものにし、論理的にグループ化したうえで、読者が実際に作業を行う順番に沿って配置する必要があります。目指すのは学習曲線に寄り添うことです。初心者が正しい文脈を無理なく築けるようにしつつ、読み進めて理解が深まるにつれて複雑な内容やカスタマイズが姿を現すようにします。優れた導線とは、その存在を意識させないものです。
a) 構造。 ドキュメントの構造と順序はCIで担保されており、トップレベルのセクションを固定するチェックによって、新しいページが既存の情報アーキテクチャに自然と収まるようになっています。
b) 関連ページ。 各ページはユーザーを次のステップへと導き、関連リンクは論理的な近さに基づいて更新されます。Quickstartは最もよく閲覧される4つのGuideページへ、各Guideページは関連するGuidesやReferencesへとつながります。リンクは本文ではなくfrontmatterに置いているため、buildの際にリンク先をページツリーと照合して検証できます。
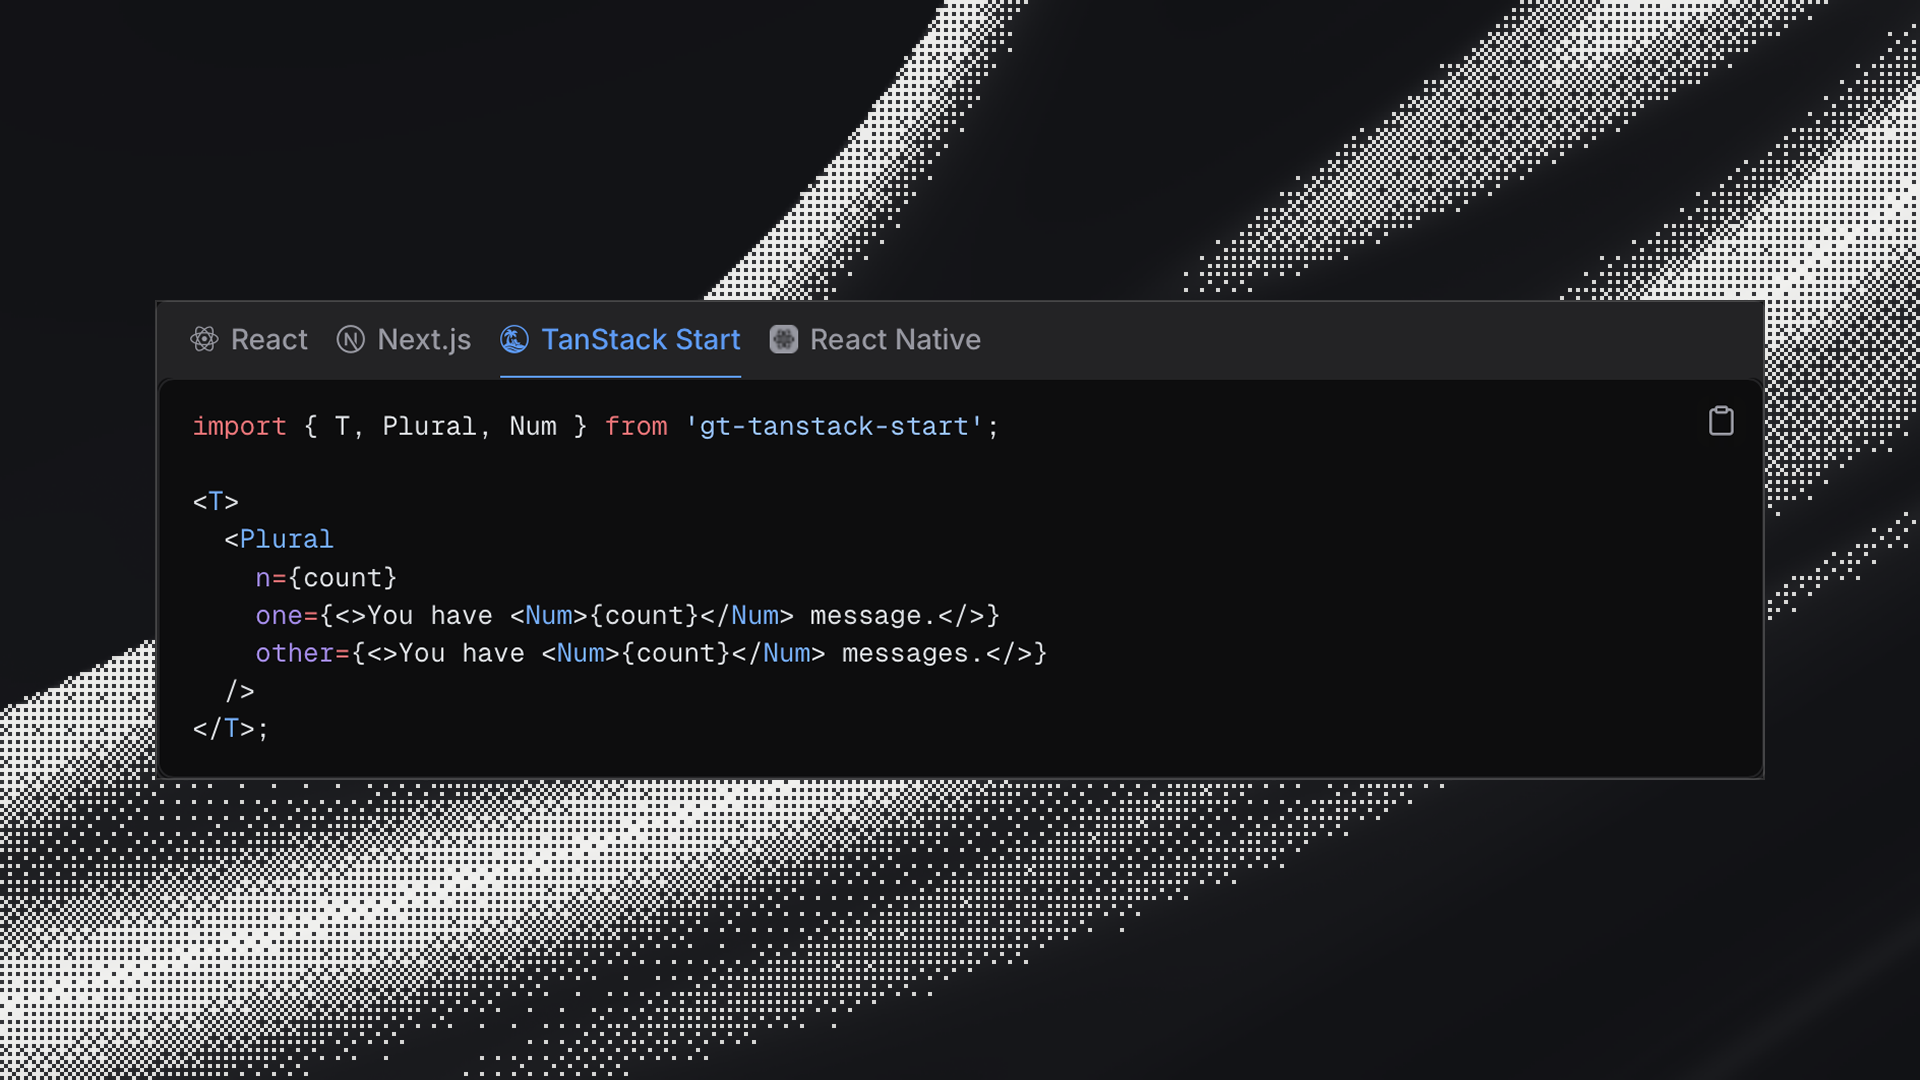
c) ユーザーの選択。 ドキュメントサイトはユーザーの選択を記憶し、最後に選ばれた言語とテーマでコンテンツを自動的に表示します。code blocksでも、ユーザーが選択したフレームワーク (React/Next.js/TanStack Start/React Native) やパッケージマネージャー (npm/yarn/bun/pnpm) のタブが自動的に維持されます。
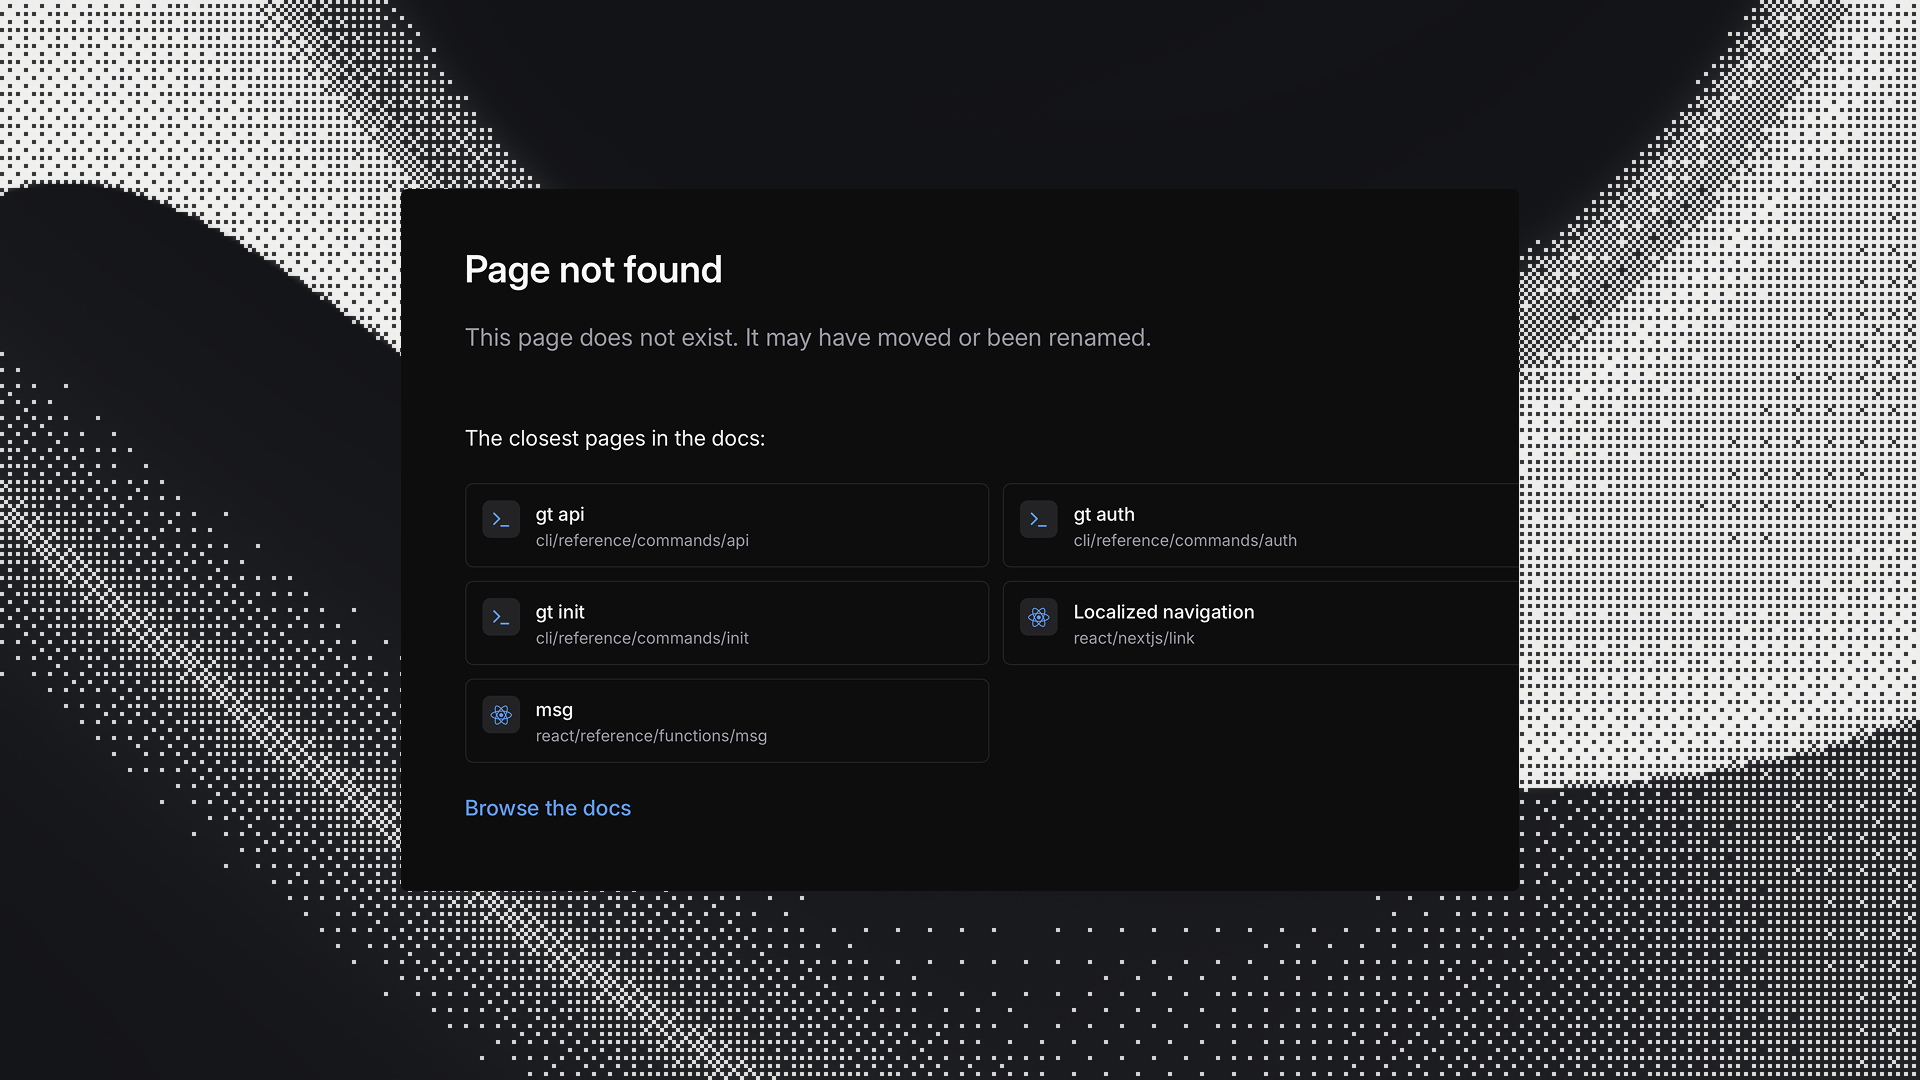
d) リンクのパス。 リンクのパスもまた細やかな工夫のひとつです。スラッグは単なるページタイトルではなく、曖昧さが生じない範囲で最も語数の少ないものにしています。文言や内容が変わっても、リンクと見出しのアンカーはそのまま維持されます。さらに、綴りの誤ったURLを捕捉して最も近い候補へリダイレクトするか、最も近い5つのページを示す専用の404を返す仕組みも組み込んでいます。
シンプルな言葉づかい
プラットフォームには多様なユーザー像が存在するため、言葉づかい自体もシンプルさと明確さを重視しています。各ページでは、仕組みの説明に入る前に、まずそのページが何を扱い、どんなときに使うのかを読者に示します。各セクションも焦点が絞られ、単独で完結したまとまりになっており、結果として人間にとってもエージェントにとっても読みやすくなっています。
各ページは特定の読者層に向けて、その層に合わせて書かれています。ドキュメントのスタイルガイドより:
読者層
そのページの読者に向けて書き、内容の深さと語彙を読者に合わせること:
- 技術的な開発者向けページ。読者は SDK、CLI、API を組み込む開発者です。型、パラメータ、ヘッダー、デフォルト値、エラー時の挙動を正確に記述し、実行可能な例を示すこと。LLMs やエージェントが読み取れる、機械可読なドキュメントにもすること。
- 非技術的なプロダクト向けページ: Dashboard と Locadex。読者は Dashboard の UI で作業するローカライゼーション担当者、翻訳者、PM です。成果と UI 上の操作を先に示し、概念は平易な言葉で説明すること。
すべての読者層に共通する明確さのルール:
「どう使うか」より先に「何であるか」「なぜ必要か」を示す。
1 文につき 1 つの考えにとどめ、短い文を優先する。
用語は初出時に定義し、略語は初出時に正式名称を示す。
まだ説明していない概念、製品用語、設定をいきなり使わない。
説明のない専門用語は避ける。避けられない用語で、1 文で説明するには複雑すぎる場合は、定義されている箇所へリンクする。
また、特定のユーザー像に向けたページも用意しました。ローカライゼーションが初めてのユーザー向けには、キーコンセプトのページで、internationalization、ローカライゼーション、翻訳、ロケール、context といった中心的な概念を平易な言葉で説明しています。主にエージェントを使うユーザー向けには、コーディングエージェントの利用のページが、機械可読なドキュメント、MCP サーバー、そのまま使える AGENTS.md ガイド(詳細は後述)へとエージェントを導きます。
エージェントに読ませるための設計
複数の情報源が指摘しているとおり、いまやドキュメントの読者の大半はエージェントです。そのため、LLMフレンドリーであることは最優先事項です。読みやすさや構成に関する原則の多くは人間向けの内容にもエージェント向けの内容にも同じように当てはまりますが、エージェントには専用の発見・取得・ツールアクセスの機能が必要です。
私たちは、VercelのAgent Readability specとAFdocs specに基づいてエージェント対応を設計しました。この2つの仕様は、AIエージェントがどのようにコンテンツを見つけて解析するかという観点から、重要な問いに答えるものです。エージェントはドキュメントのページを発見し、その内容を辿れるか。コンテキストウィンドウに収まるクリーンなMarkdownコンテンツを読めるか。検索・取得を行い、適切なAIツールを使えるか。
実装の主なポイントは次のとおりです。
llms.txt: llmstxt.org標準に準拠したドキュメントの索引。加えてllms-index.txt(全ページ) 、llms-scope.txt/<section>(セクションごとの索引) 、llms-full.txt(より大きなコンテキストを読み込めるツール向けの全コーパス) というレイヤーも用意sitemap.xmlとsitemap.md: 全ページの機械可読なマップ- 全ページの生Markdown: 任意のドキュメントURLに
.mdまたは.mdxを付けるだけです。Accept: text/markdownを送信する既知のAIクローラーやエージェントには、自動的にMarkdownが返されます - MCP (Model Context Protocol) サーバー: ローカルのstdio利用向けの
@generaltranslation/mcpnpmパッケージ、https://mcp.gtx.devでホストされるエンドポイント (streamable HTTP、SSE版もあり) 、およびAPIキーで認証するプロジェクトスコープのエンドポイントhttps://api.gtx.dev/mcp /openapi.json(および/openapi.yaml) で提供する機械可読なOpenAPI仕様。各エンドポイントのリファレンスページからリンクしています- RAG (検索拡張生成) 向けにチャンク単位で構造化されたコンテンツ。各セクションは一つの完結した内容を扱い、見出し階層も一貫しています
- 寛容な
robots.txt: AIクローラーをブロックすることはありません
プロセス、メンテナンス、スタイルガイド
このドキュメントの大規模なリファクタリングは、1人の人間のライター (私です!) とさまざまなAIツールの協働で進め、チームの他のメンバーからも意見をもらいました。私たちの原則は、コンテンツ・意味・論理の流れの理解は人間の執筆力と判断力で担保し、そこで得た知見を厳密で網羅的なスタイルガイドに落とし込み、AIによってスタイルガイドをスケールさせ、コードベースの更新に追随し続ける、というものです。
まず網羅的な調査パスを実行し、900ページ、117,000語以上の文章にわたる既存ドキュメントの全コンテンツのインベントリを作成しました。この素材のインデックスをもとに、手書きのマップに沿ってコンテンツを再構成しました。必要な最上位セクションは何か、フレームワークをどうグループ化しどう並べるか、各ページの目的は何か、といった観点です。各セクションの代表的なページは自分で執筆・編集し、明快さ、シンプルさ、ユーザージャーニーの支援という原則を反映させました。この手作業の部分だけで、1か月以上の集中的な作業を要しました。特にQuickstartは多くのテストを必要とし、私たちのi18n libraryのエンジニアが大幅に手を入れています。
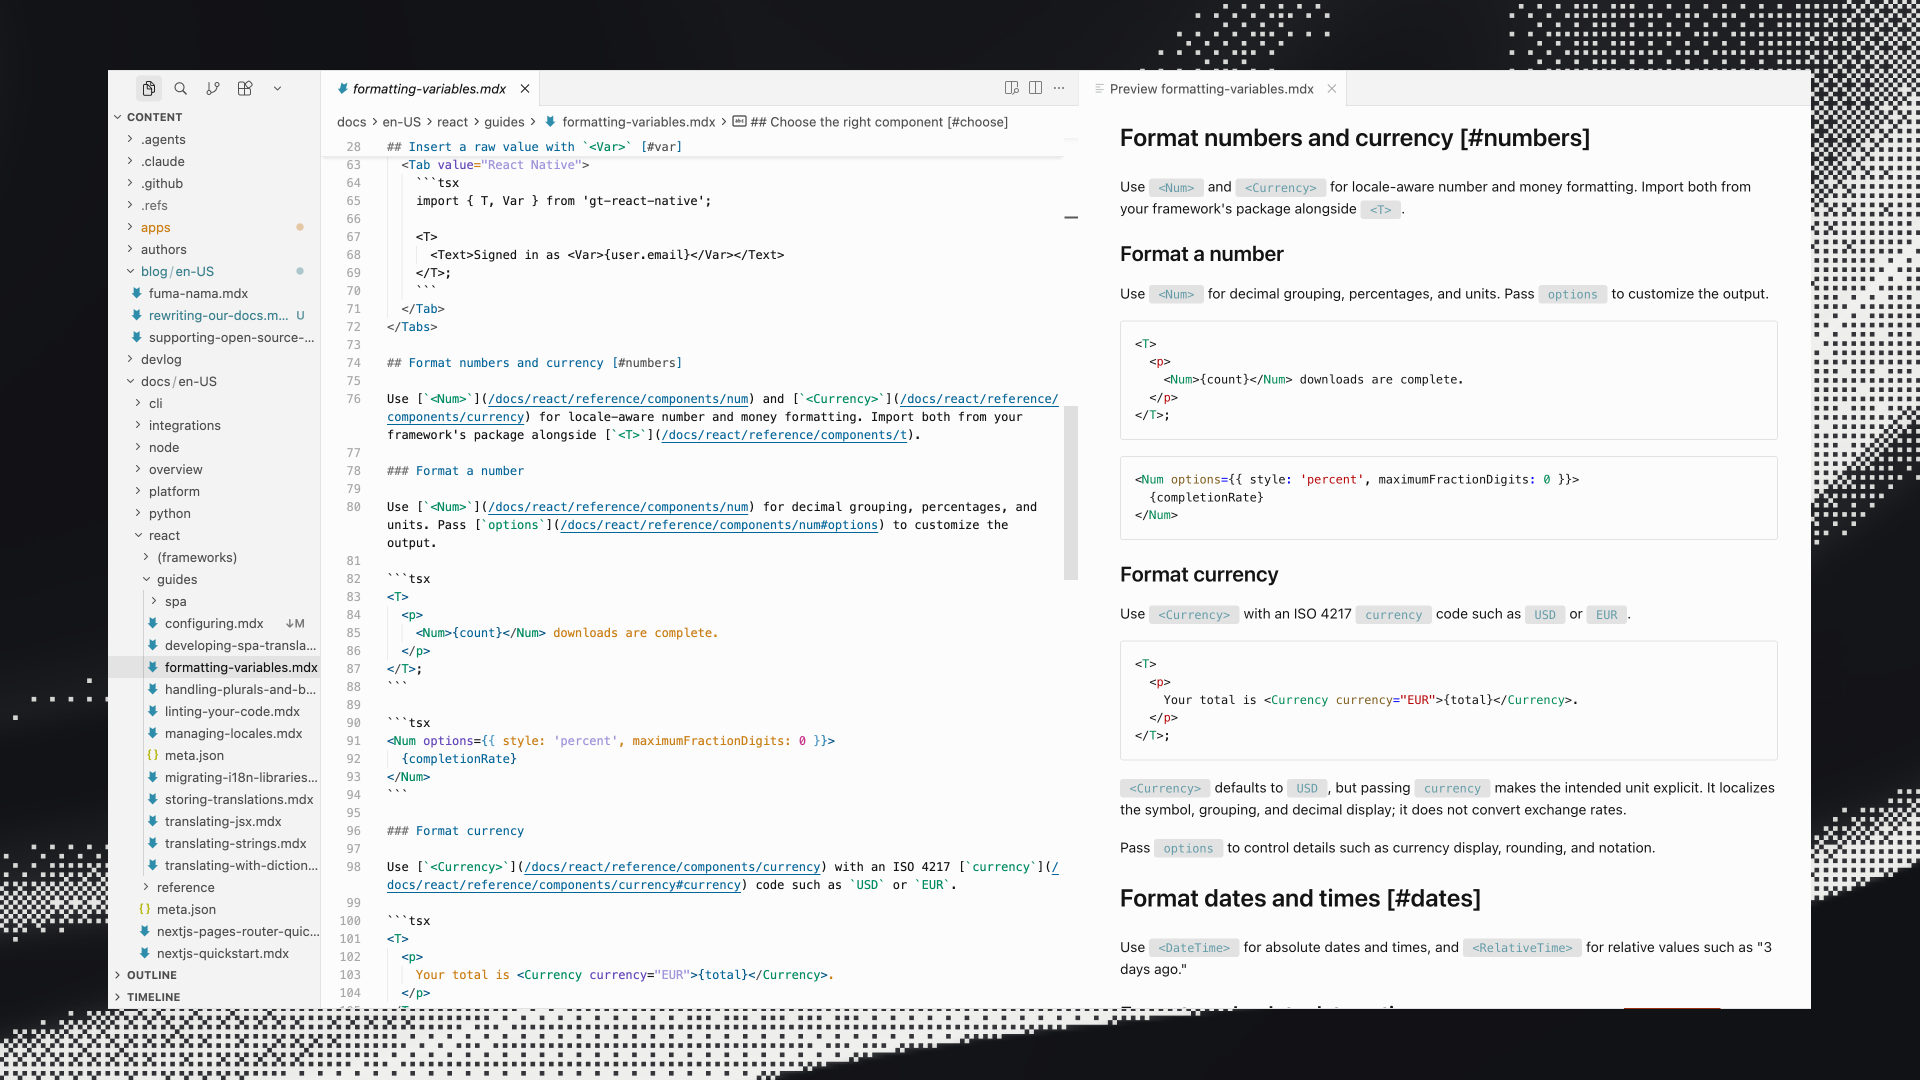
このプロセスで特に面白かったのは、Markdownプレビューパネルを活用しながらCursorで直接執筆した点です。おかげで私の変更内容がバージョン履歴として正確に残り、その後エージェントに私の変更 (さらには思考プロセス) をガイドラインやルールへと一般化し、ドキュメントのスタイルガイドに追加して、全ページに適用するよう手軽に頼めるようになりました。構造であれコンテンツであれ、ドキュメントに編集を加えるたびに、その変更を一般化してスタイルガイドとともに適用しています。
その結果、私たちのドキュメントスタイルガイドは非常に詳細で、私たちのドキュメントの方針にぴったり沿ったものになっており、さまざまなエッジケースやユーザーの目的を網羅し、830行・13,000語を超えています。このスタイルガイドはCIで強制され、エージェントが容易に適用できる一連の運用手順であり、メタ的な執筆原則から非常に具体的なルールやスキルまでをカバーしています。さらに、クラウドエージェントが毎日実行され、ドキュメントを実際にリリースされた挙動と同期させます。 エージェントはカバレッジの抜け、不正確な記述、古くなった例を探します。新規プロジェクトを立ち上げて機能をローカルでテストし、スタイルガイドに従って文章をlintもします。
これらのスタイルガイドのルールは、お客様向けの翻訳品質のために適用しているcontextとカスタムプロンプトのルールと似ています。
パート2: ビジュアルデザイン
こうした構成の見直しによって、ドキュメントがより直感的で使いやすくなっていれば幸いです。ご意見・ご感想はいつでも歓迎します。各ドキュメントページには、ページの編集、問題の報告、質問のためのボタンが用意されています。
ブログのパート2では、ドキュメントのUIとインタラクションの再設計、そしてFumadocs上で独自のビジュアルをどのように構築したかを紹介します。ぜひご期待ください。