Taylor Fang

Progettare per la duplice esperienza di lettura
La documentazione racconta un prodotto e la sua struttura. Dovrebbe aiutare l'utente a costruirsi un modello mentale del prodotto e del suo funzionamento, guidandolo lungo un percorso intuitivo e rispondendo alle domande che emergono strada facendo. La documentazione deve semplificare i concetti per i nuovi utenti e svelare la complessità man mano che l'utente avanza.
Ma c'è anche un nuovo lettore. Gli agenti stanno rapidamente affiancando e superando gli utenti umani come destinatari di primo piano, e hanno bisogno di un'architettura pensata su misura per scoprire, leggere e analizzare la documentazione.
La nostra documentazione è cresciuta in modo organico, mentre la piattaforma si espandeva per supportare nuovi framework e integrazioni. Struttura, ordinamento e linguaggio, però, hanno iniziato a perdere coerenza.
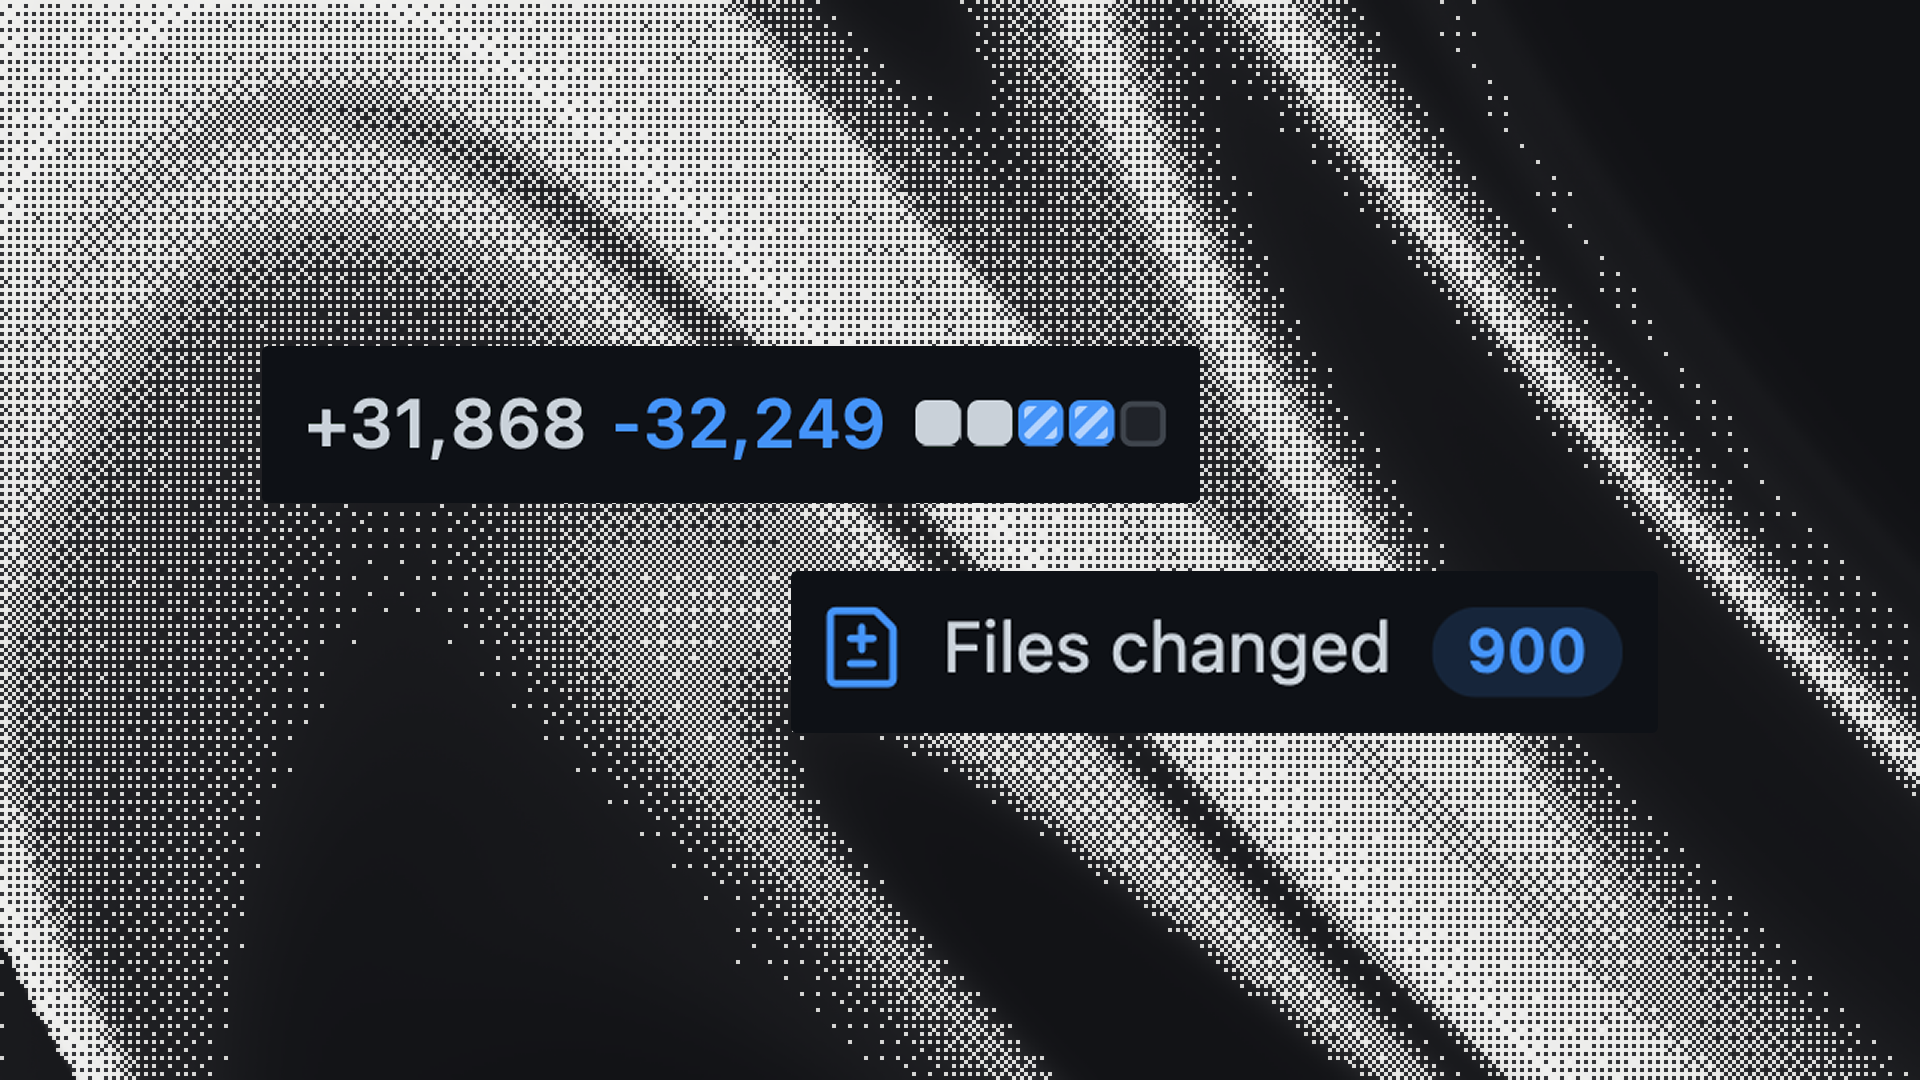
Abbiamo deciso di ricostruire la documentazione da zero, con un'attenzione precisa all'esperienza di lettura sia per gli umani sia per gli agenti. Il refactoring iniziale ha interessato 900 file (+31.868 / −32.249 righe). Abbiamo creato una guida di stile di 13.000 parole con regole su pubblico, anatomia della pagina, stile e grammatica. Oggi la documentazione è mantenuta da un agente cloud che ogni giorno esegue il lint rispetto alla guida di stile.
Per la leggibilità da parte degli agenti, esponiamo anche llms.txt e llms-full.txt per indicizzare il sito, e rendiamo disponibile ogni pagina della documentazione come Markdown non elaborato aggiungendo .md al suo URL. Pubblichiamo una pagina di documentazione per gli agenti di coding con un file AGENTS.md pronto all'uso che spiega a un agente come configurare, usare e tradurre correttamente, insieme al nostro server MCP e alla specifica OpenAPI machine-readable.
Questo post illustra le modifiche che abbiamo apportato e ciò che abbiamo imparato.
Fonti di ispirazione
Abbiamo studiato e tratto ispirazione dalle best practice e dalla documentazione per sviluppatori che ammiriamo:
- Gli scritti di Lee Robinson sulla documentazione. «Mantieni semplice l'esperienza iniziale e rivela la complessità poco a poco.» I suoi dieci principi includono: veloce, leggibile, nativa per l'IA, curata, reattiva. E localizzata, ovviamente. (Con Lee abbiamo lavorato davvero, per localizzare la documentazione di Cursor!)
- Gli scritti di Fuma Nama sulla documentazione. Consiglia uno stile di scrittura semplice e di costruire una struttura più logica con grassetti, intestazioni, collegamenti ipertestuali, elenchi e tabelle. Fuma sostiene inoltre che, per l'esperienza di lettura, la navigazione possa contare più del contenuto stesso. (Scopri di più sulla filosofia di Fuma nella nostra intervista.)
- Gli scritti di Devin Logan sulla documentazione pronta per gli agenti. Devin scrive che il nuovo standard di riferimento è che gli utenti accedano alla documentazione tramite agenti. Delinea i passaggi per renderla leggibile dall'IA: sul fronte dei contenuti, questi devono spiegare i sistemi e offrire passaggi eseguibili; sul fronte della piattaforma, le pagine devono essere individuabili e alleggerite per gli agenti.
- Abbiamo osservato da vicino la documentazione per sviluppatori che amiamo: Linear per chiarezza e semplicità, Replicate per una navigazione gerarchica chiara, shadcn/ui per il design curato, Next.js per il linguaggio rivolto agli sviluppatori e le funzionalità per la community, Convex per la grafica accattivante, Stripe per le funzionalità integrate e molte altre ancora.
Percorsi utente
Abbiamo riorganizzato pagine e linguaggio attorno a ciò che l'utente vuole ottenere, invece di limitarci a descrivere le funzionalità tecniche. Ogni sezione segue la stessa struttura portante: Quickstart, Guides e Reference.
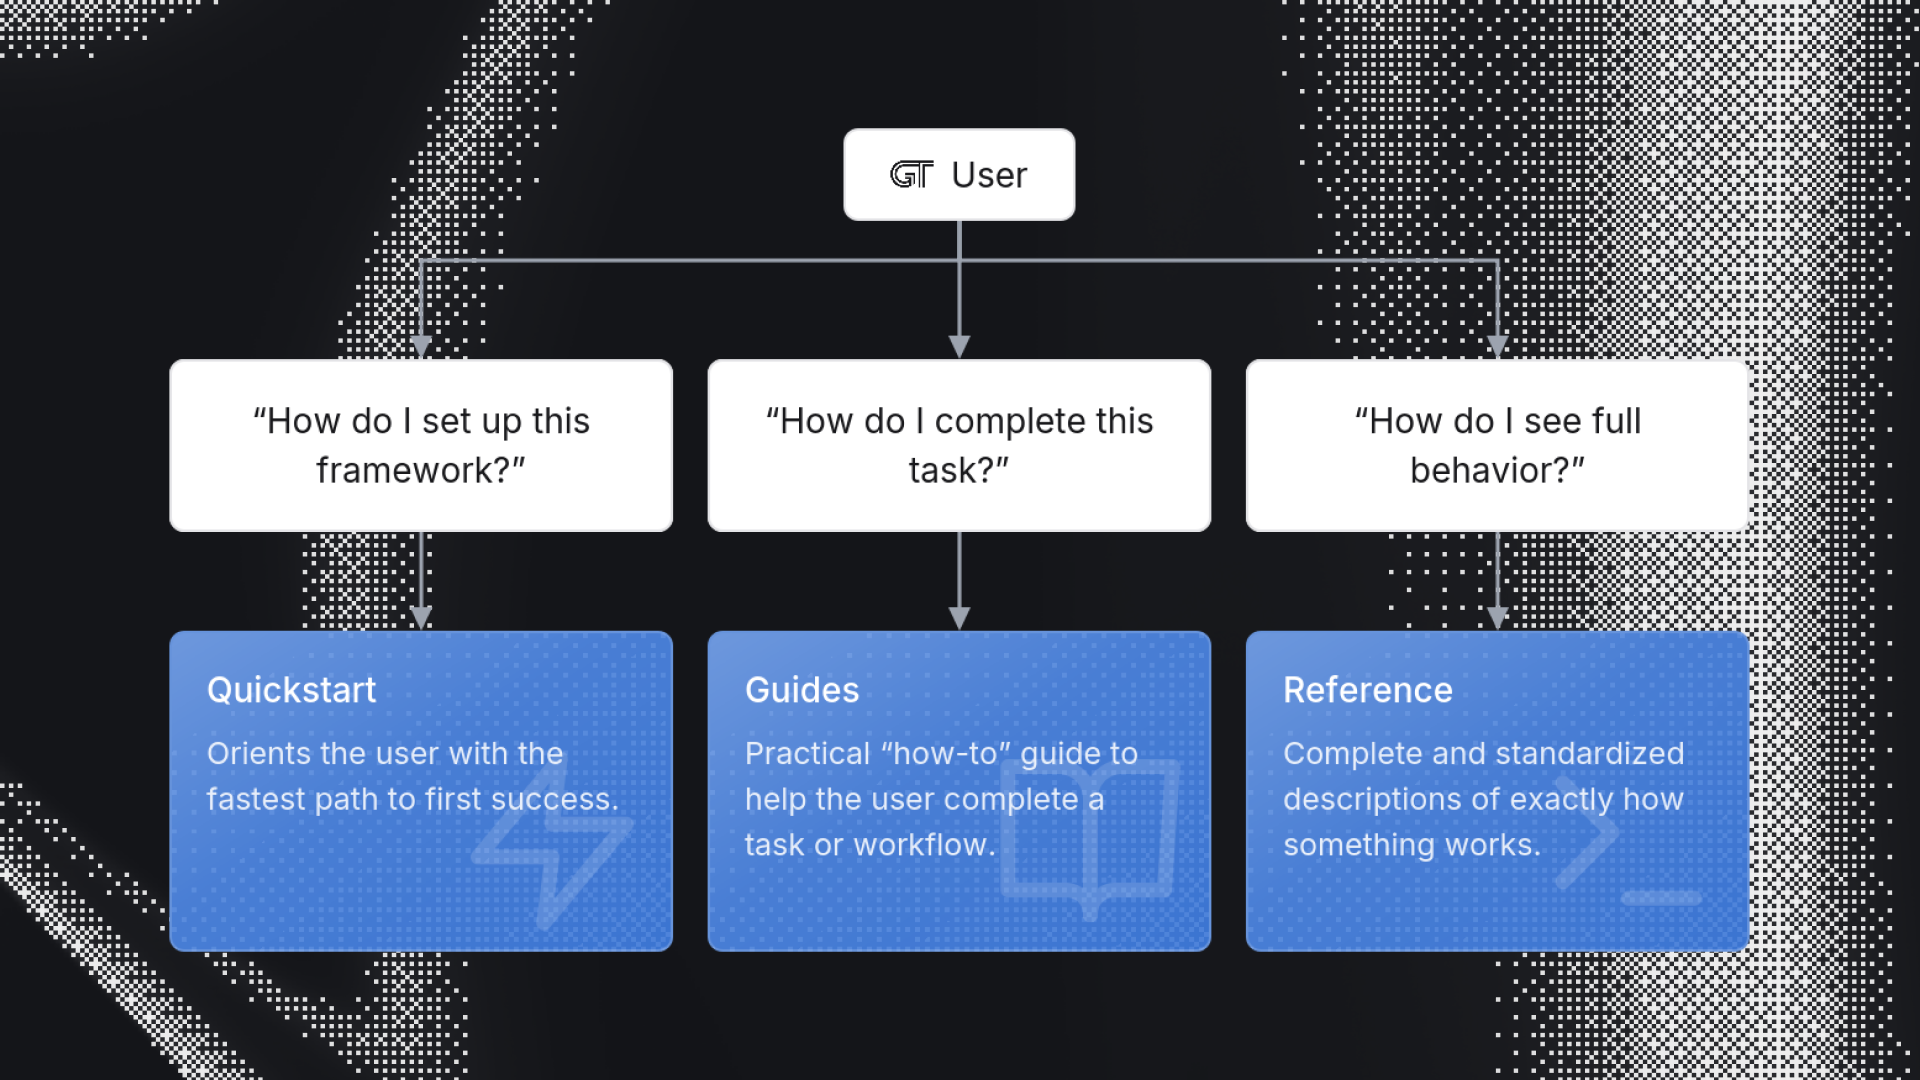
I titoli delle guide usano forme gerundive e descrivono i compiti da portare a termine, come "Revisione e modifica delle traduzioni" o "Gestione di plurali e branch". Un nuovo utente che vuole completare un workflow non deve indovinare quale termine tecnico cercare: può semplicemente cercare l'azione che vuole compiere.
Un piacevole effetto collaterale è che le nostre guide si posizionano ai primi posti sui motori di ricerca, comparendo anche come primo risultato Google per ricerche come "React managing locales", "React translating jsx", "Configuring a Vite SPA i18n", "React plurals and branches", "Translating rrweb" e molte altre.
Il sito della documentazione è costruito su Fumadocs, il cui creatore abbiamo recentemente intervistato sulla sua filosofia di una reader experience bella e composable.
Flusso logico e intuitivo
I Docs dovrebbero aiutare l'utente a costruire un modello mentale del prodotto e del suo funzionamento. Per questo è importante che il flusso sia intuitivo sia nella navigazione sia all'interno di ogni pagina. L'ordinamento deve essere ragionato e significativo, raggruppato in modo logico e disposto nell'ordine in cui è probabile che il lettore compia un'azione. L'obiettivo è seguire la curva di apprendimento, così che i principianti possano costruire facilmente il contesto corretto, con complessità e personalizzazioni che emergono man mano che gli utenti leggono e approfondiscono. Un flusso intuitivo dovrebbe risultare invisibile.
a) Struttura. La struttura e l'ordinamento dei nostri docs sono garantiti in CI, tramite un controllo che fissa le sezioni top-level in modo che ogni nuova pagina si inserisca nell'architettura informativa esistente.
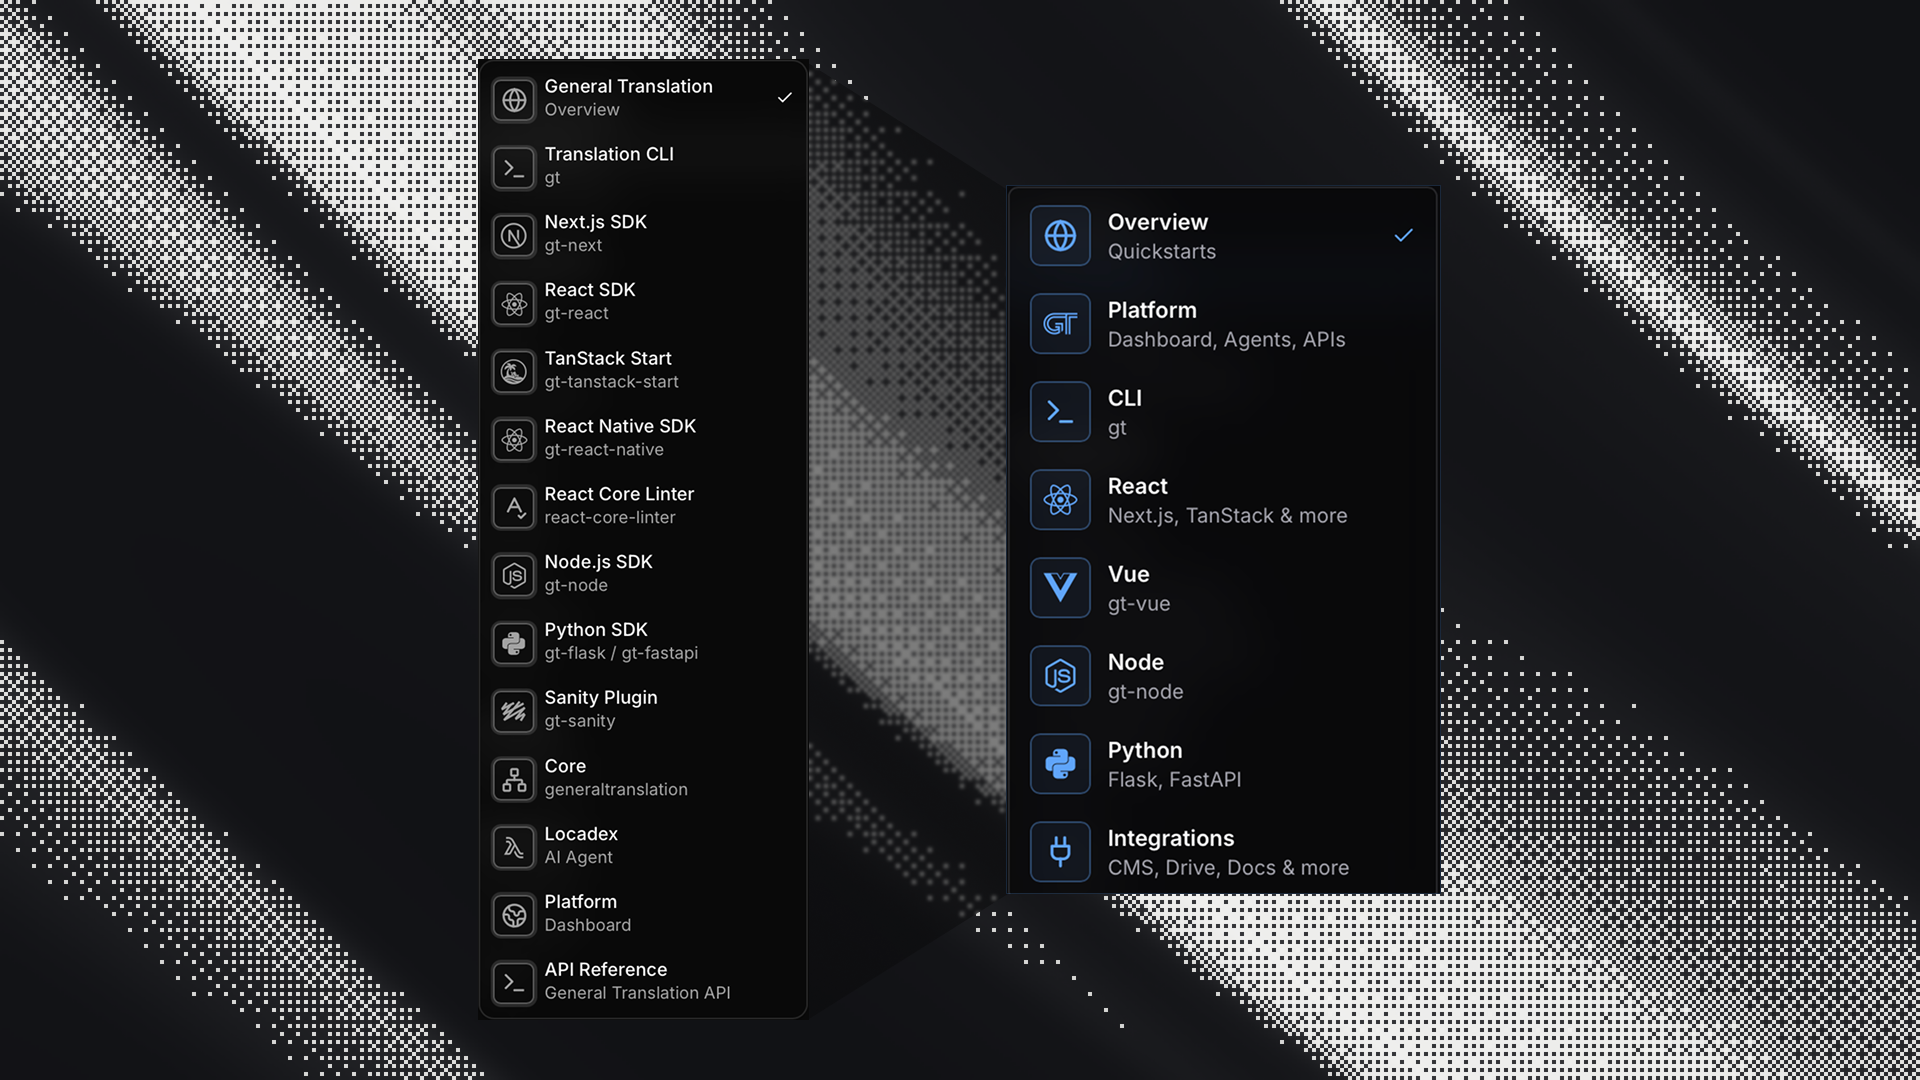
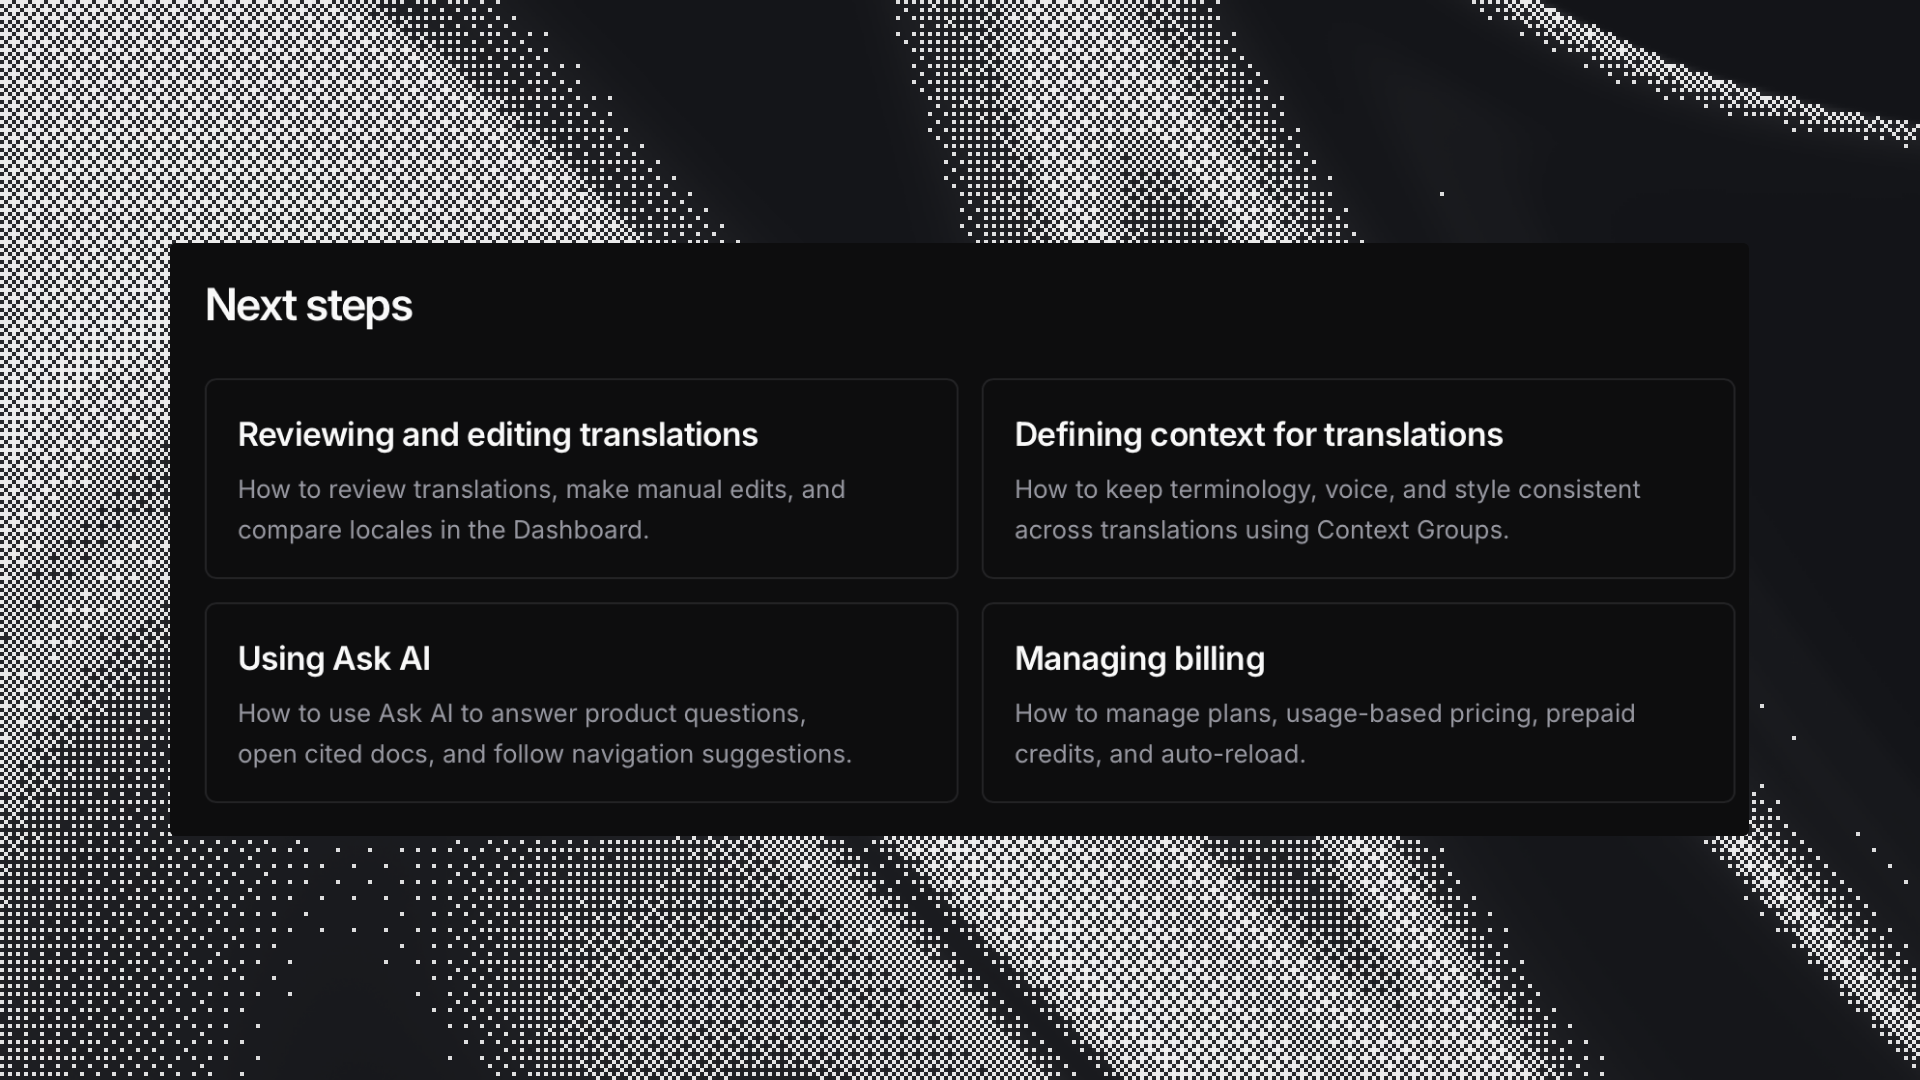
b) Pagine correlate. Ogni pagina guida gli utenti verso i passaggi successivi, con i link correlati aggiornati in base alla prossimità logica. Il Quickstart rimanda alle quattro pagine Guide più consultate, e ogni pagina Guide rimanda a Guides o References correlate. I link risiedono nel frontmatter anziché nel corpo del testo, così che la build possa verificare le destinazioni rispetto all'albero delle pagine.
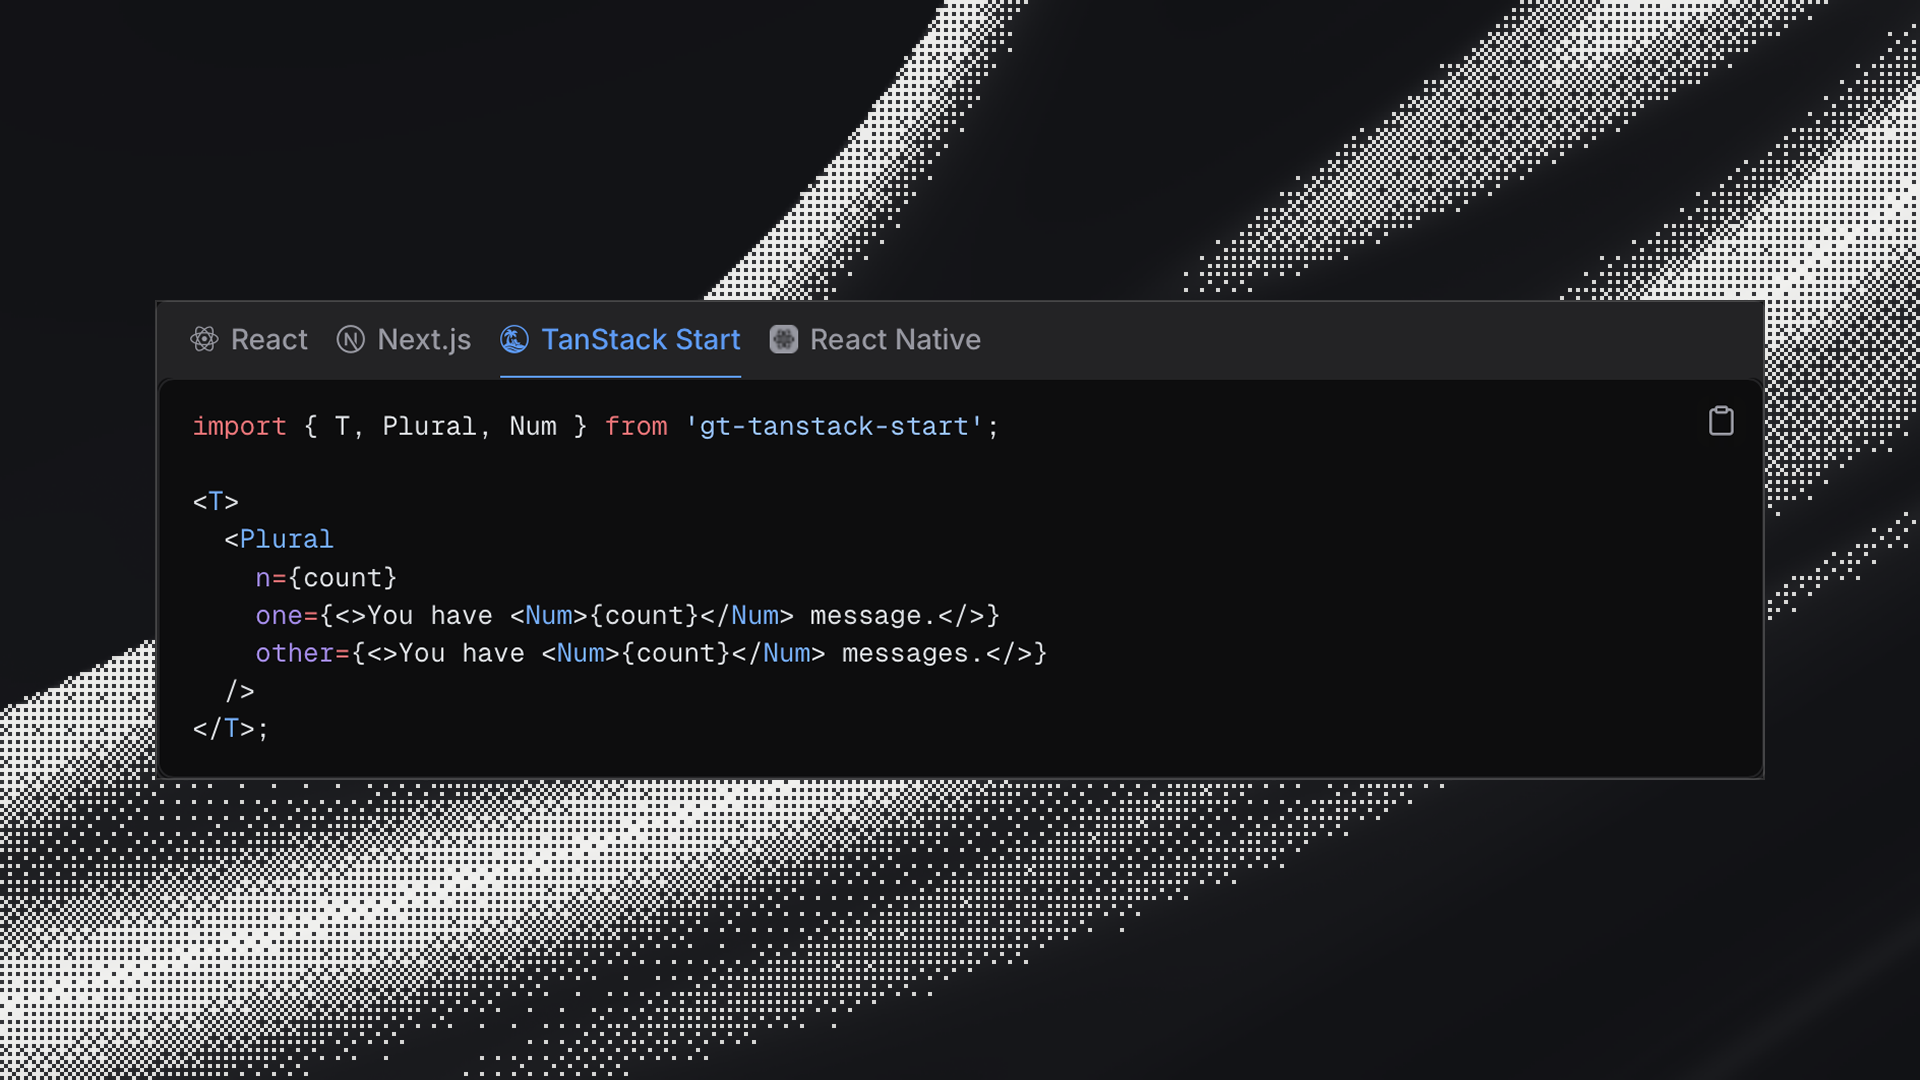
c) Selezioni dell'utente. Il sito dei docs ricorda le selezioni dell'utente e mostra automaticamente i contenuti nell'ultima lingua e nell'ultimo tema scelti. Anche i code blocks preservano automaticamente la scheda selezionata dall'utente per il framework (React vs. Next.js vs. TanStack Start vs. React Native) e il package manager (npm vs. yarn vs. bun vs. pnpm).
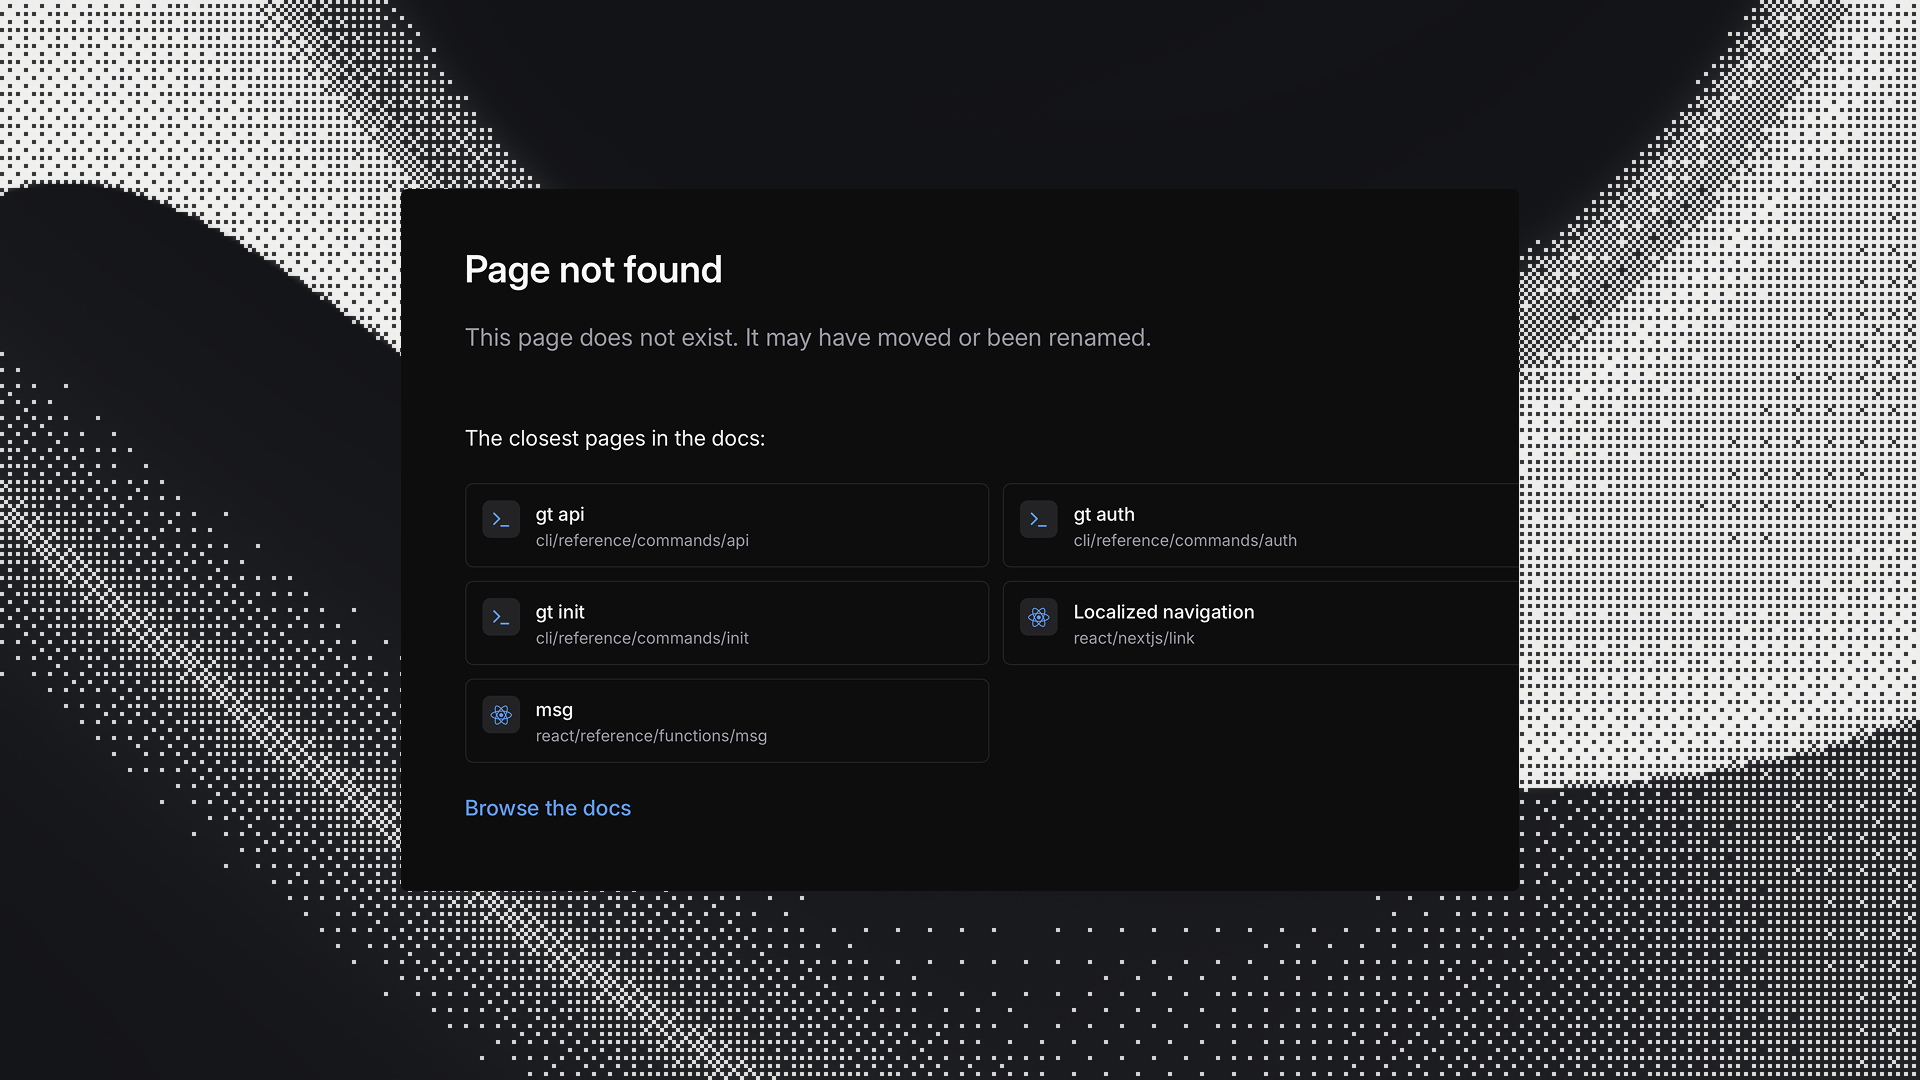
d) Percorsi dei link. Anche i percorsi dei nostri link sono un piccolo dettaglio curato: gli slug non coincidono semplicemente con il titolo della pagina, ma usano il minor numero di parole possibile pur restando non ambigui. I link e le ancore delle intestazioni rimangono invariati anche se il testo o il contenuto cambiano. Abbiamo inoltre previsto un sistema che intercetta gli URL scritti male per reindirizzare alla corrispondenza più vicina o a una pagina 404 speciale con le cinque pagine più affini.
Linguaggio semplice
Data la varietà di profili utente presenti sulla nostra piattaforma, il linguaggio stesso punta su semplicità e chiarezza. Ogni pagina orienta anzitutto il lettore spiegando di cosa tratta e quando usarla, prima di approfondire come funziona. Anche ogni sezione è un blocco mirato e autonomo, che, a quanto pare, risulta più facile da leggere sia per le persone sia per gli agenti.
Ogni pagina è rivolta e adattata a un pubblico specifico. Dalla nostra guida di stile per la documentazione:
Pubblico
Scrivi per il lettore della singola pagina, calibrando su di lui livello di dettaglio e lessico:
- Pagine tecniche, rivolte agli sviluppatori. I lettori sono sviluppatori che integrano l'SDK, la CLI o l'API. Sii preciso su tipi, parameters, header, valori predefiniti e comportamento in caso di errore; mostra esempi eseguibili. Assicurati che la documentazione sia anche machine-readable per LLMs e agenti.
- Pagine non tecniche, rivolte al prodotto: Dashboard e Locadex. I lettori sono responsabili della localization, traduttori e project manager che lavorano nella UI della Dashboard. Parti dagli outcomes e dalle azioni nella UI; spiega i concetti con un linguaggio semplice.
Regole di chiarezza valide per ogni pubblico:
Parti da che cos'è e dal perché, prima del come.
Un'idea per frase; prediligi frasi brevi.
Definisci un termine la prima volta che compare ed esplicita gli acronimi al primo utilizzo.
Non usare un concetto, un termine di prodotto o un'impostazione prima di averli introdotti.
Evita il gergo non spiegato. Se un termine è inevitabile e troppo complesso da spiegare in una frase, inserisci un collegamento al punto in cui è definito.
Abbiamo scritto anche pagine dedicate a profili utente specifici. Per chi si avvicina per la prima volta alla localization, la pagina Key concepts spiega i concetti fondamentali con un linguaggio elementare: internationalization, localization, traduzione, locales e context. Per chi lavora soprattutto con gli agenti, la pagina Using coding agents indirizza gli agenti alla nostra machine-readable docs, al server MCP e alla guida drop-in AGENTS.md (ne parliamo più avanti).
Progettare per la lettura da parte degli agenti
Come hanno raccontato diverse fonti, oggi gli agenti costituiscono la maggior parte dei lettori della documentazione. Per questo la compatibilità con gli LLM è una priorità assoluta. Molti dei principi di leggibilità e di struttura valgono allo stesso modo per i contenuti destinati alle persone e per quelli destinati agli agenti; questi ultimi, però, hanno bisogno di capacità specifiche di scoperta, recupero e accesso agli strumenti.
Abbiamo progettato la nostra predisposizione per gli agenti seguendo l'Agent Readability spec di Vercel e la specifica AFdocs. Queste due specifiche affrontano alcune questioni chiave legate al modo in cui gli agenti IA trovano e analizzano i contenuti. Gli agenti riescono a individuare le pagine della documentazione e a orientarsi tra gli argomenti trattati? Riescono a leggere contenuti Markdown puliti che rientrino in una finestra di contesto? Riescono a cercare, recuperare e usare gli strumenti IA corretti?
Gli elementi principali della nostra implementazione sono:
llms.txt: un indice della documentazione conforme allo standard llmstxt.org, con livelli aggiuntivi:llms-index.txt(tutte le pagine),llms-scope.txt/<section>(indici per sezione) ellms-full.txt(l'intero corpus per gli strumenti in grado di caricare un contesto più ampio)sitemap.xmlesitemap.md: mappe machine-readable di ogni pagina- Markdown non elaborato per ogni pagina: basta aggiungere
.mdo.mdxa qualsiasi URL della documentazione. I crawler e gli agenti IA riconosciuti che invianoAccept: text/markdownricevono automaticamente il Markdown - Un server MCP (Model Context Protocol): il package npm
@generaltranslation/mcpper l'uso locale via stdio, un endpoint ospitato suhttps://mcp.gtx.dev(streamable HTTP, con una variante SSE) e un endpoint project-scoped suhttps://api.gtx.dev/mcpautenticato con una chiave API - Una specifica OpenAPI machine-readable su
/openapi.json(e/openapi.yaml), collegata da ogni pagina di riferimento degli endpoint - Contenuti strutturati in blocchi per il RAG (retrieval-augmented generation), in cui ogni sezione contiene un concetto completo e le gerarchie delle intestazioni sono coerenti
- Un
robots.txtpermissivo: i crawler IA non vengono mai bloccati
Processo, manutenzione e guida di stile
Il rilascio di questo enorme refactor della nostra documentazione è stato frutto della collaborazione tra un autore umano (io!) e vari strumenti di IA, con il contributo del resto del team. Il nostro principio è affidarci alla scrittura e al giudizio umani per la comprensione di contenuto, significato e flusso logico, tradurre ciò che impariamo in una guida di stile rigorosa e completa e usare l'IA per scalare la guida di stile e restare in sync con gli aggiornamenti della nostra base di codice.
Ho iniziato con una fase di ricognizione completa per ottenere un inventario di tutti i contenuti esistenti della documentazione, distribuiti su 900 pagine e oltre 117.000 parole di prosa. Partendo dall'indice di questo materiale grezzo, ho ristrutturato i contenuti seguendo una mappa scritta a mano: quali sezioni di alto livello ci servivano, come raggruppare e ordinare i framework e quale fosse lo scopo di ogni pagina. Ho scritto e revisionato pagine rappresentative in ciascuna sezione per incorporare i nostri principi di chiarezza, semplicità e supporto al percorso dell'utente. La parte manuale del processo ha richiesto oltre un mese di lavoro intenso. I quickstart in particolare hanno richiesto molti test, e gli ingegneri della nostra i18n library hanno apportato modifiche significative.
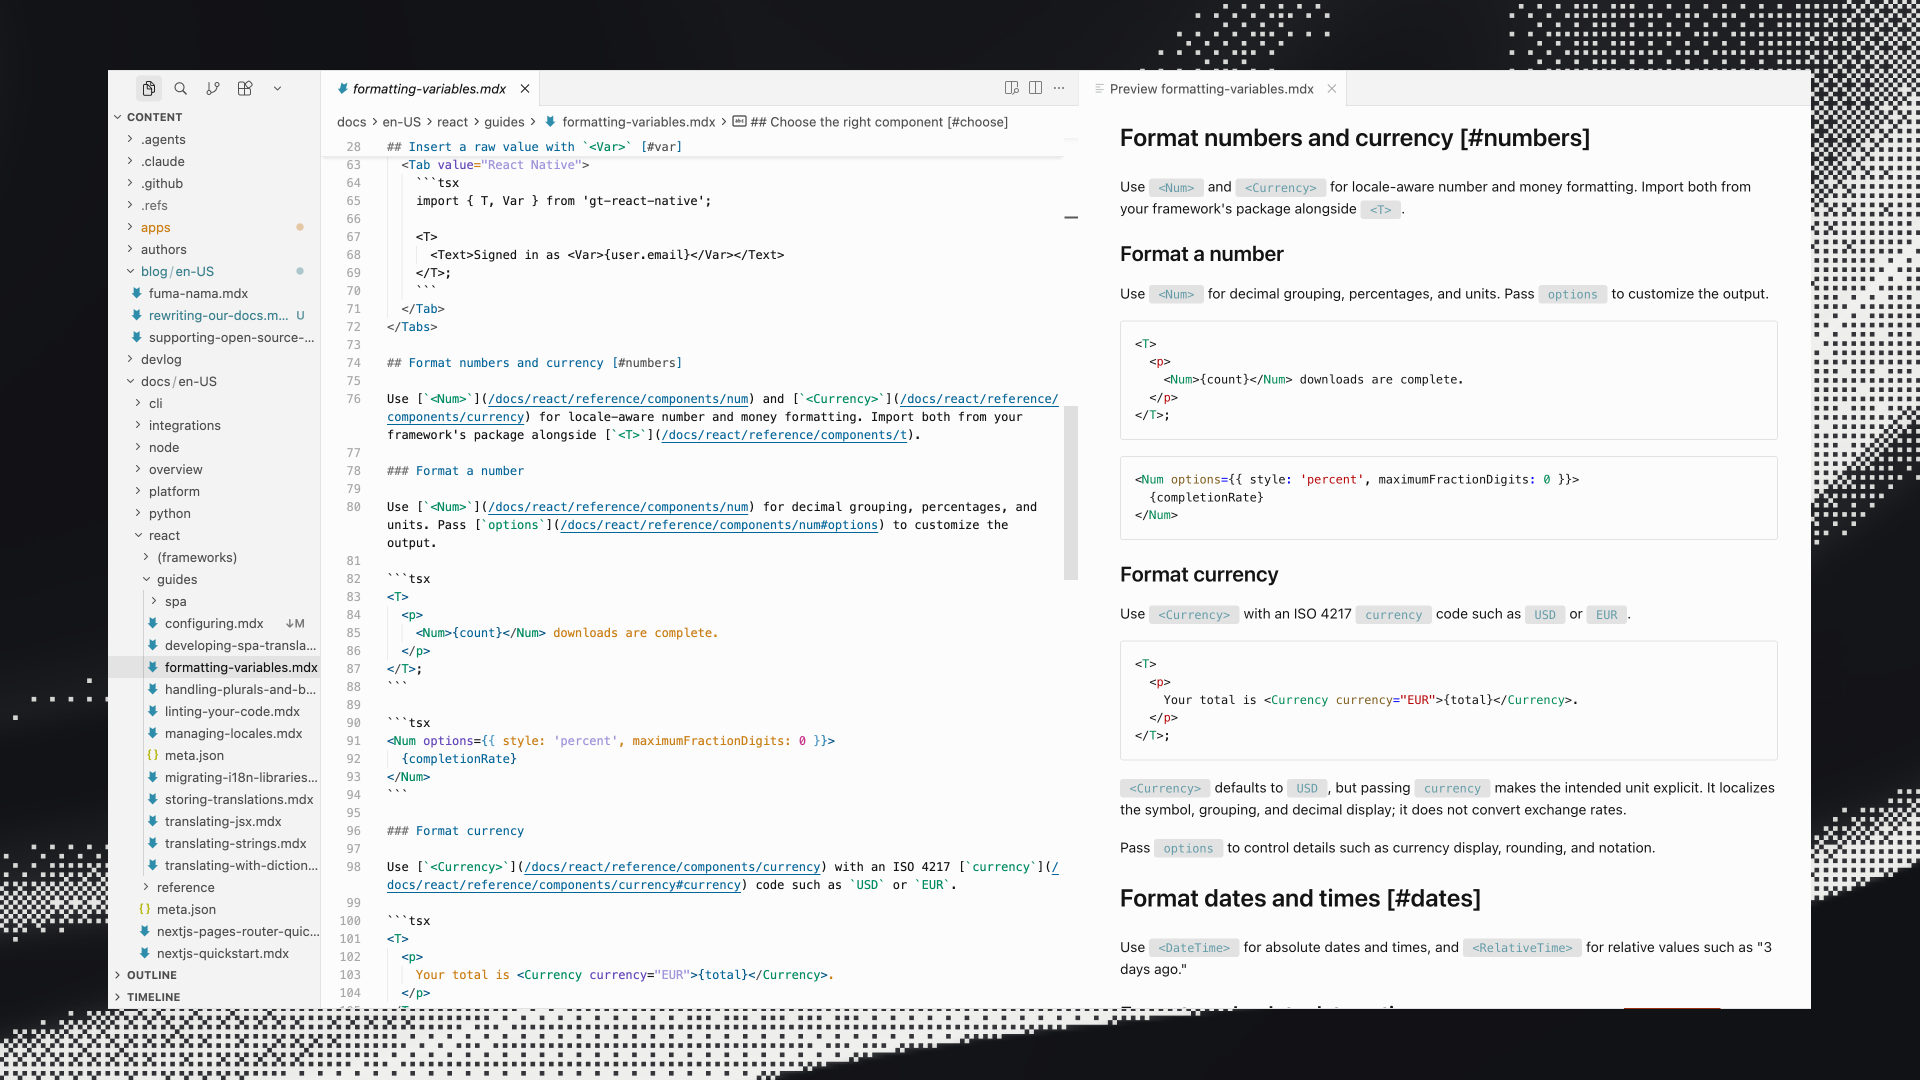
Una parte affascinante del processo è stata scrivere direttamente in Cursor, sfruttando al meglio il pannello di anteprima Markdown. In questo modo ogni mia modifica veniva tracciata nella cronologia delle versioni, e potevo poi chiedere facilmente a un agente di generalizzare le mie modifiche (e persino il mio ragionamento) in linee guida e regole, aggiungerle alla guida di stile della documentazione e applicarle a ogni pagina. Ogni volta che modifichiamo la documentazione, nella struttura o nel contenuto, generalizziamo e applichiamo queste modifiche tramite la guida di stile.
Grazie a questo processo la nostra guida di stile della documentazione è estremamente dettagliata e calibrata sulle nostre precise preferenze documentali: copre una varietà di casi limite e di obiettivi degli utenti, con oltre 830 righe e 13.000 parole. La guida di stile è un insieme di procedure operative applicate in CI e facilmente utilizzabili dagli agenti, che copre sia principi generali di scrittura sia regole e competenze molto specifiche. Un agente cloud viene inoltre eseguito ogni giorno e mantiene la documentazione in sync con il comportamento rilasciato. L'agente cerca lacune di copertura, imprecisioni ed esempi obsoleti. Crea un progetto da zero e testa le funzionalità in locale, e applica anche il lint alla prosa secondo la guida di stile.
Le regole della guida di stile sono simili alle regole di context e ai prompt personalizzati che applichiamo per garantire la qualità delle traduzioni ai nostri clienti.
Parte 2: design visivo
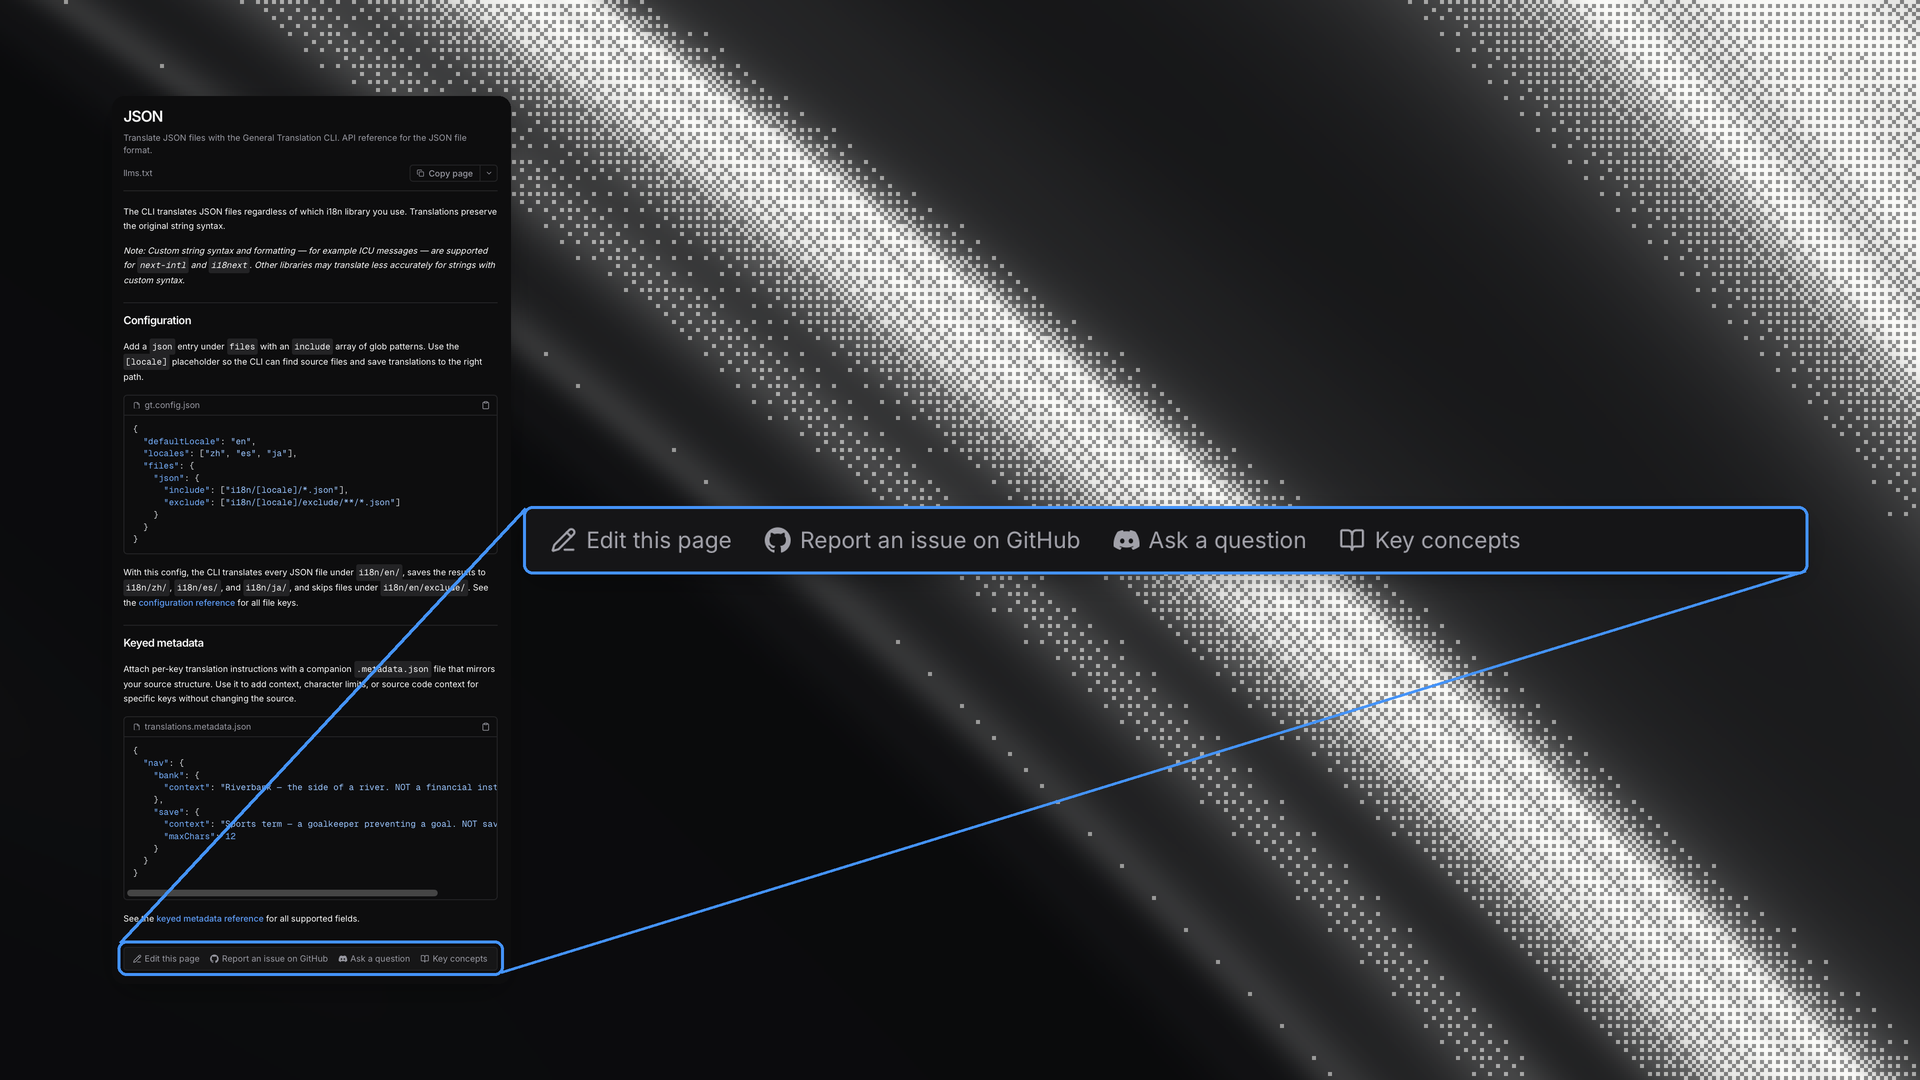
Ci auguriamo che queste modifiche strutturali abbiano reso la nostra documentazione più intuitiva e facile da consultare. Il tuo feedback è sempre benvenuto: ogni pagina della documentazione ha dei pulsanti per modificarla, segnalare un problema o porre una domanda.
Non perderti la parte 2 del nostro blog, dedicata al redesign della UI e dell'interazione della documentazione e a come abbiamo realizzato elementi visivi personalizzati con Fumadocs.