Taylor Fang

为双重阅读体验而设计
文档传达的是产品本身及其支撑结构。它应当帮助用户建立对产品及其运作方式的心智模型,沿着符合直觉的路径引导用户,并在过程中解答疑问。文档必须为新用户简化概念,再随着用户的深入逐步揭示复杂性。
如今还多了一类新读者。 智能体正迅速取代人类用户,成为文档的一等读者,而它们需要专门的架构来发现、读取和解析文档。
随着平台不断扩展以支持新的框架和集成,我们的文档也随之野蛮生长,结构、顺序和措辞逐渐开始走样。
我们决定从零重建文档,有意识地兼顾人类与智能体两类读者的阅读体验。首轮重构改动了 900 个文件 (+31,868 / −32,249 行) 。我们编写了一份 13,000 字的风格指南,明确了受众定位、页面结构以及文体与语法规则。如今,文档由一个每日运行的云端智能体维护,对照风格指南进行检查。
为提升智能体的可读性,我们还提供了 llms.txt 和 llms-full.txt 来为站点建立索引;只需在 URL 后追加 .md,即可将任意文档页面以原始 Markdown 形式返回。我们还上线了一个面向编码智能体的文档页面,内含一份即插即用的 AGENTS.md,告诉智能体如何正确地完成设置、使用和翻译,并同时提供我们的 MCP 服务器 和机器可读的 OpenAPI 规范。
本文将介绍我们所做的改动以及从中获得的经验。
灵感来源
我们调研并借鉴了我们所欣赏的最佳实践与开发者文档:
- Lee Robinson 关于文档的文章。"让初次体验保持简单,再逐步揭开复杂之处。" 他提出的十条原则包括:快速、易读、AI 原生、精致、响应式。当然,还有本地化。 (我们还真与 Lee 合作本地化了 Cursor 的文档!)
- Fuma Nama 关于文档的文章。他建议采用简洁的写作风格,并善用加粗、标题、超链接、列表和表格来搭建更具逻辑性的结构。Fuma 还认为,就阅读体验而言,导航可能比内容更重要。 (在我们的访谈中进一步了解 Fuma 的理念。)
- Devin Logan 关于面向智能体的文档的文章。Devin 写道,如今的新常态是用户通过智能体来访问文档。她梳理了提升 AI 可读性的做法:在内容层面,内容需要讲清系统原理并给出可执行的步骤;在平台层面,页面需要易于被发现,并为智能体做精简处理。
- 我们还仔细研究了自己钟爱的开发者文档:Linear 的清晰与简洁、Replicate 清晰的层级导航、shadcn/ui 优美的设计、Next.js 贴近开发者的语言和社区功能、Convex 赏心悦目的视觉效果、Stripe 的嵌入式功能,以及其他许多优秀文档。
用户旅程
我们围绕用户想要达成的目标重新组织了页面和表述,而不再只是罗列技术能力。每个板块都遵循同一条主线:Quickstart、指南和 Reference。
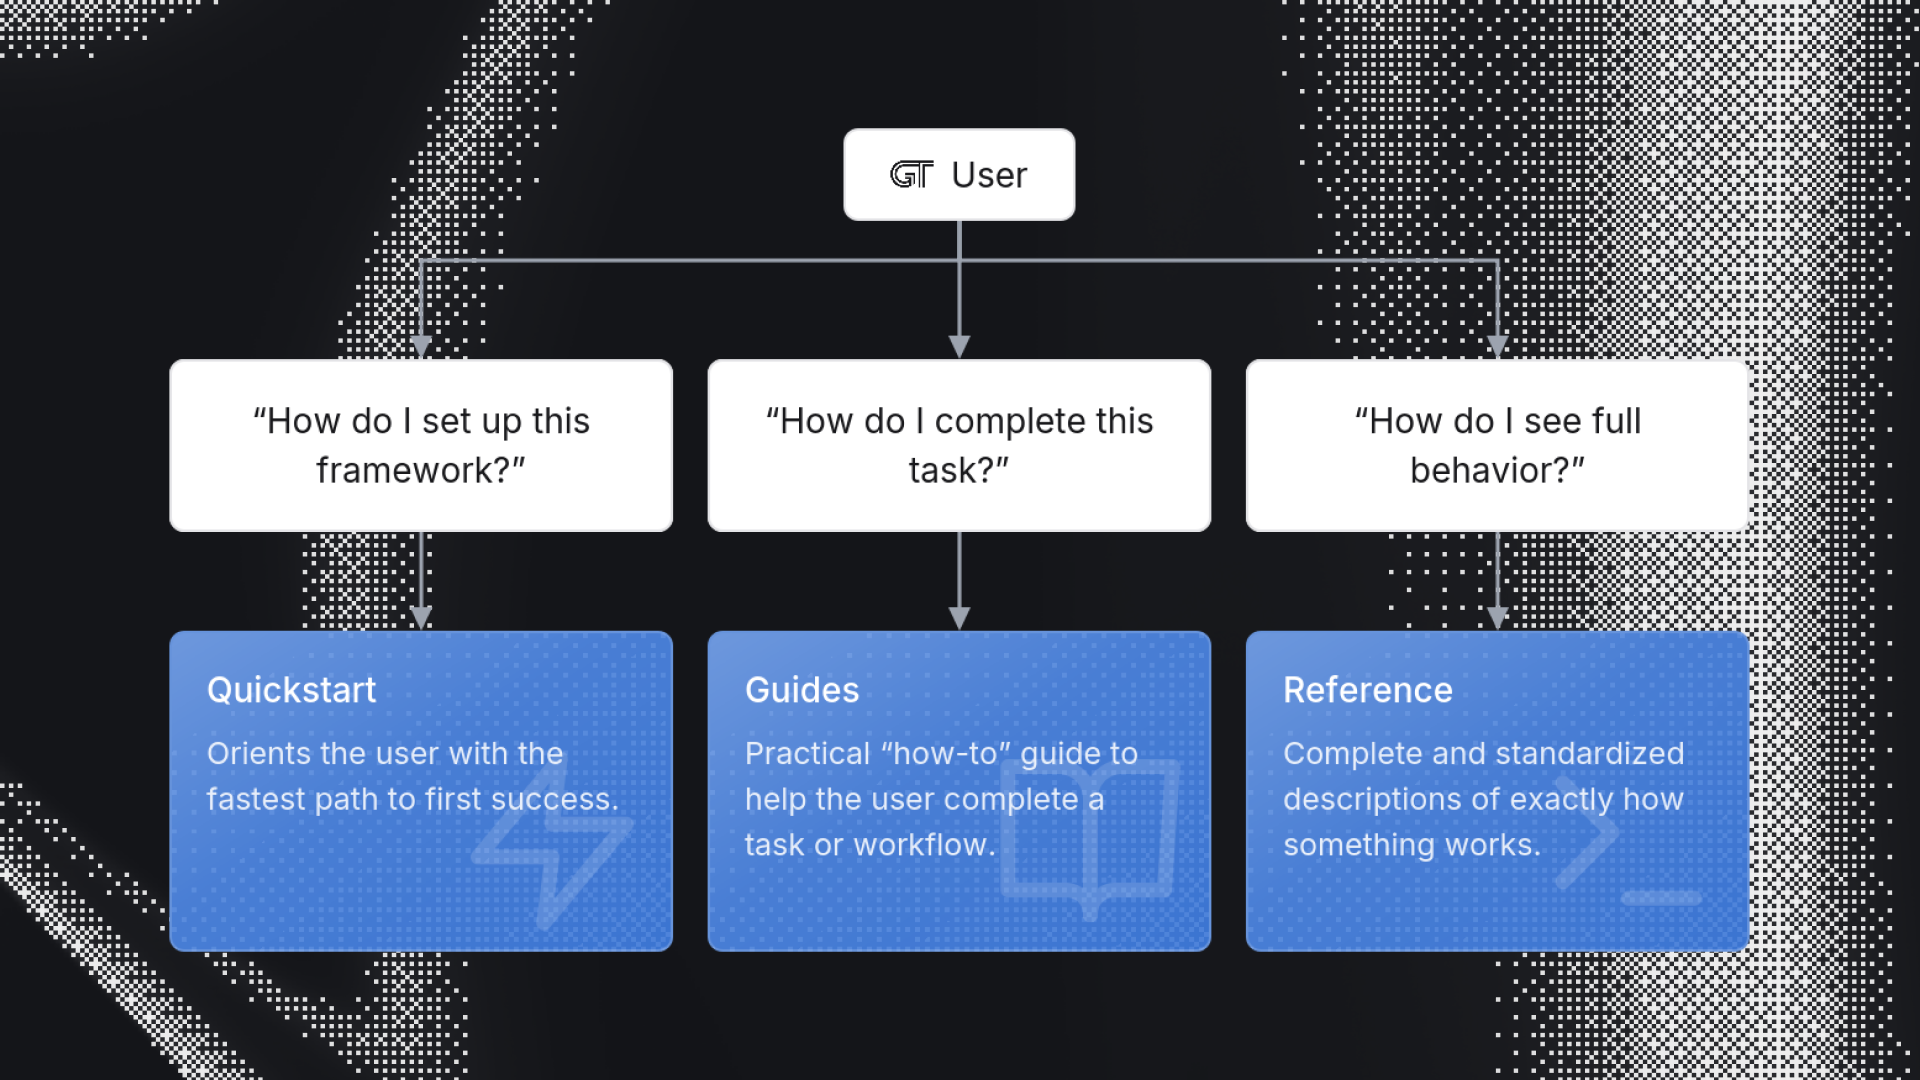
指南均以动名词形式、按待完成的任务命名,例如「审校和编辑翻译」或「处理 plurals 和 branches」。想要走通某个 workflow 的新用户无需琢磨该搜哪个术语,直接搜索想执行的操作即可。
一个不错的附带效果是,我们的文档指南本身 SEO 排名很高,在「React managing locales」「React translating jsx」「Configuring a Vite SPA i18n」「React plurals and branches」「Translating rrweb」等搜索中都位居 Google 结果首位。
文档站点本身基于 Fumadocs 构建,我们最近还采访了它的作者,聊了聊他对打造美观、可组合的阅读体验的理念。
逻辑清晰、符合直觉的流程
文档应当帮助用户建立对产品及其运作方式的心智模型。为此,导航和每个页面内部都需要有符合直觉的流程。内容的排序应当经过深思熟虑、言之有物,按逻辑分组,并依照读者可能执行操作的先后顺序排列。目标是贴合学习曲线,让初学者能轻松建立正确的上下文,而复杂特性与自定义能力则随着阅读的深入逐步展开。真正符合直觉的流程,应当让人察觉不到它的存在。
a) 结构。 我们的文档结构和排序由 CI 强制保证,其中有一项检查会固定顶层章节,让新页面能自然嵌入既有的信息架构。
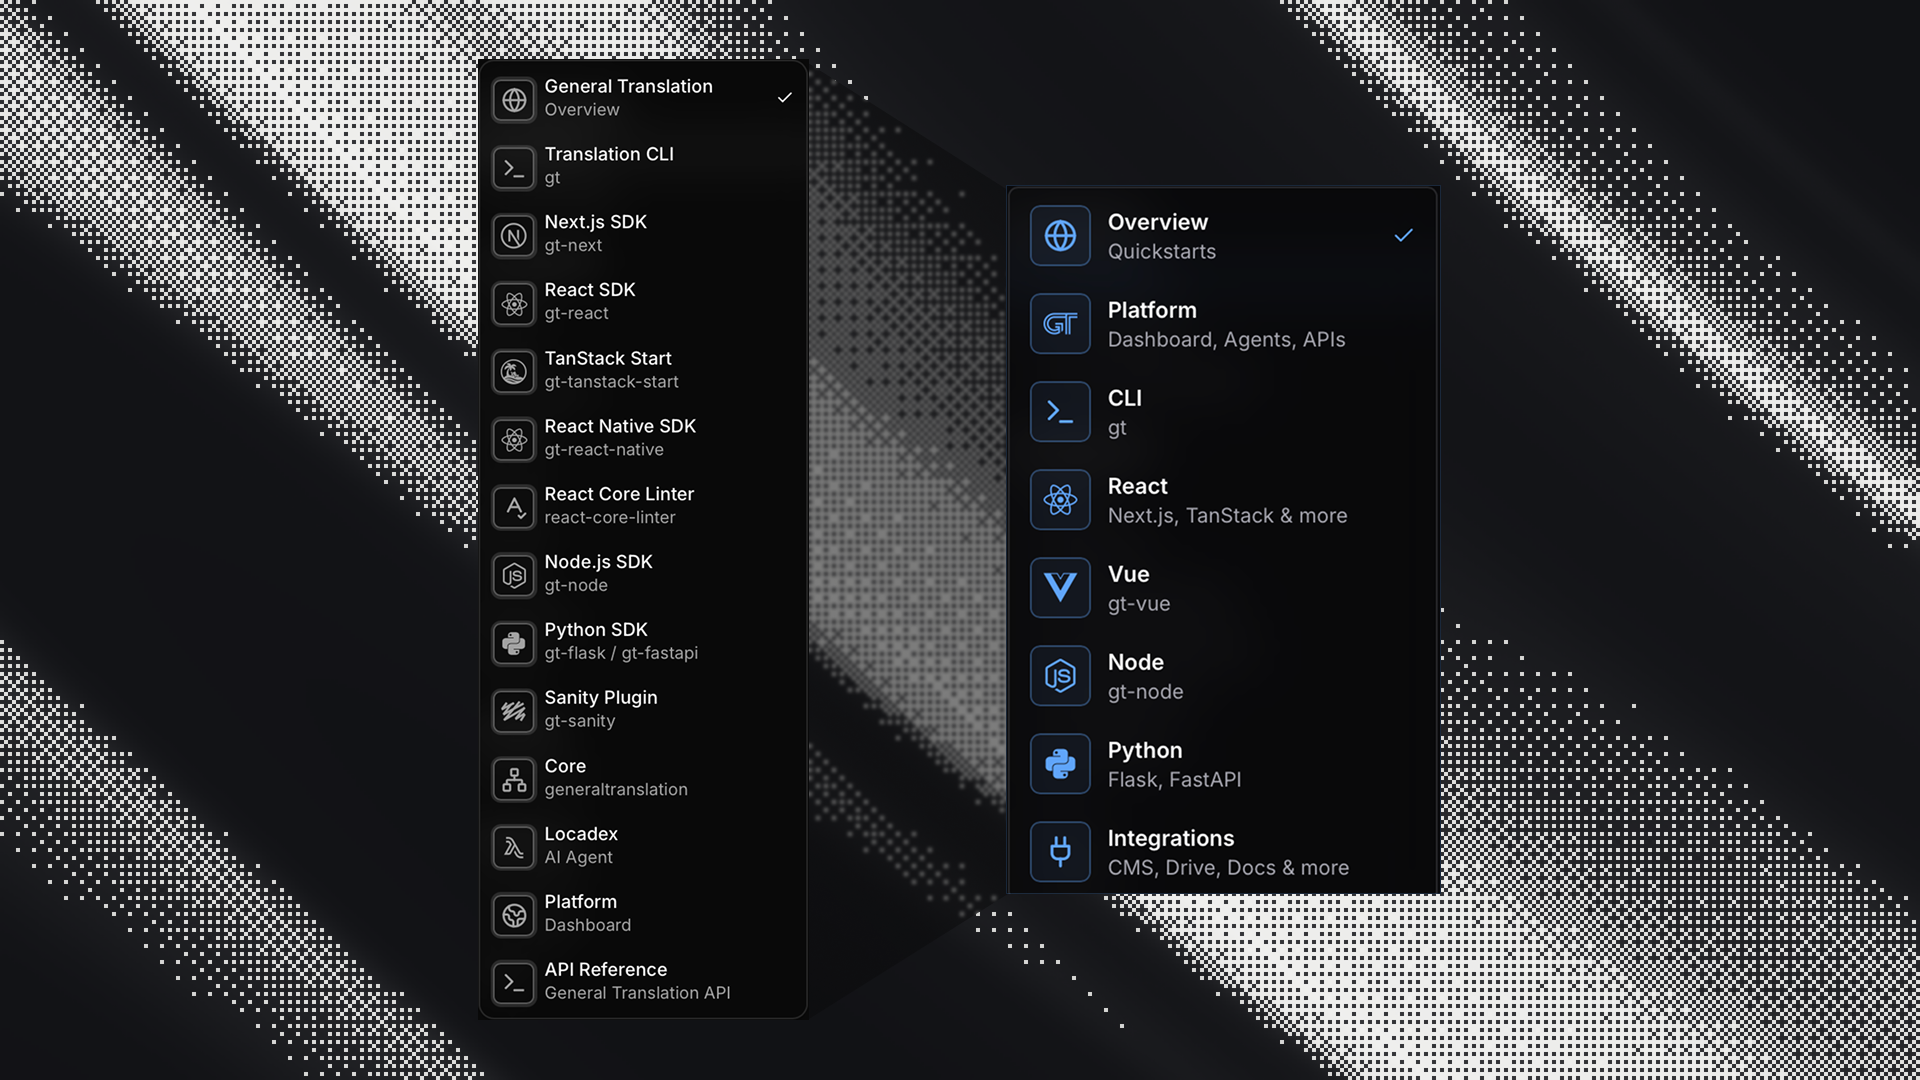
b) 相关页面。 每个页面都会引导用户进入下一步,相关链接按逻辑相近度更新。Quickstart 指向浏览量最高的四个 Guide 页面,每个 Guide 页面则指向相关的 Guides 或 References。链接写在 frontmatter 中而非正文里,这样构建过程就能对照页面树校验链接目标。
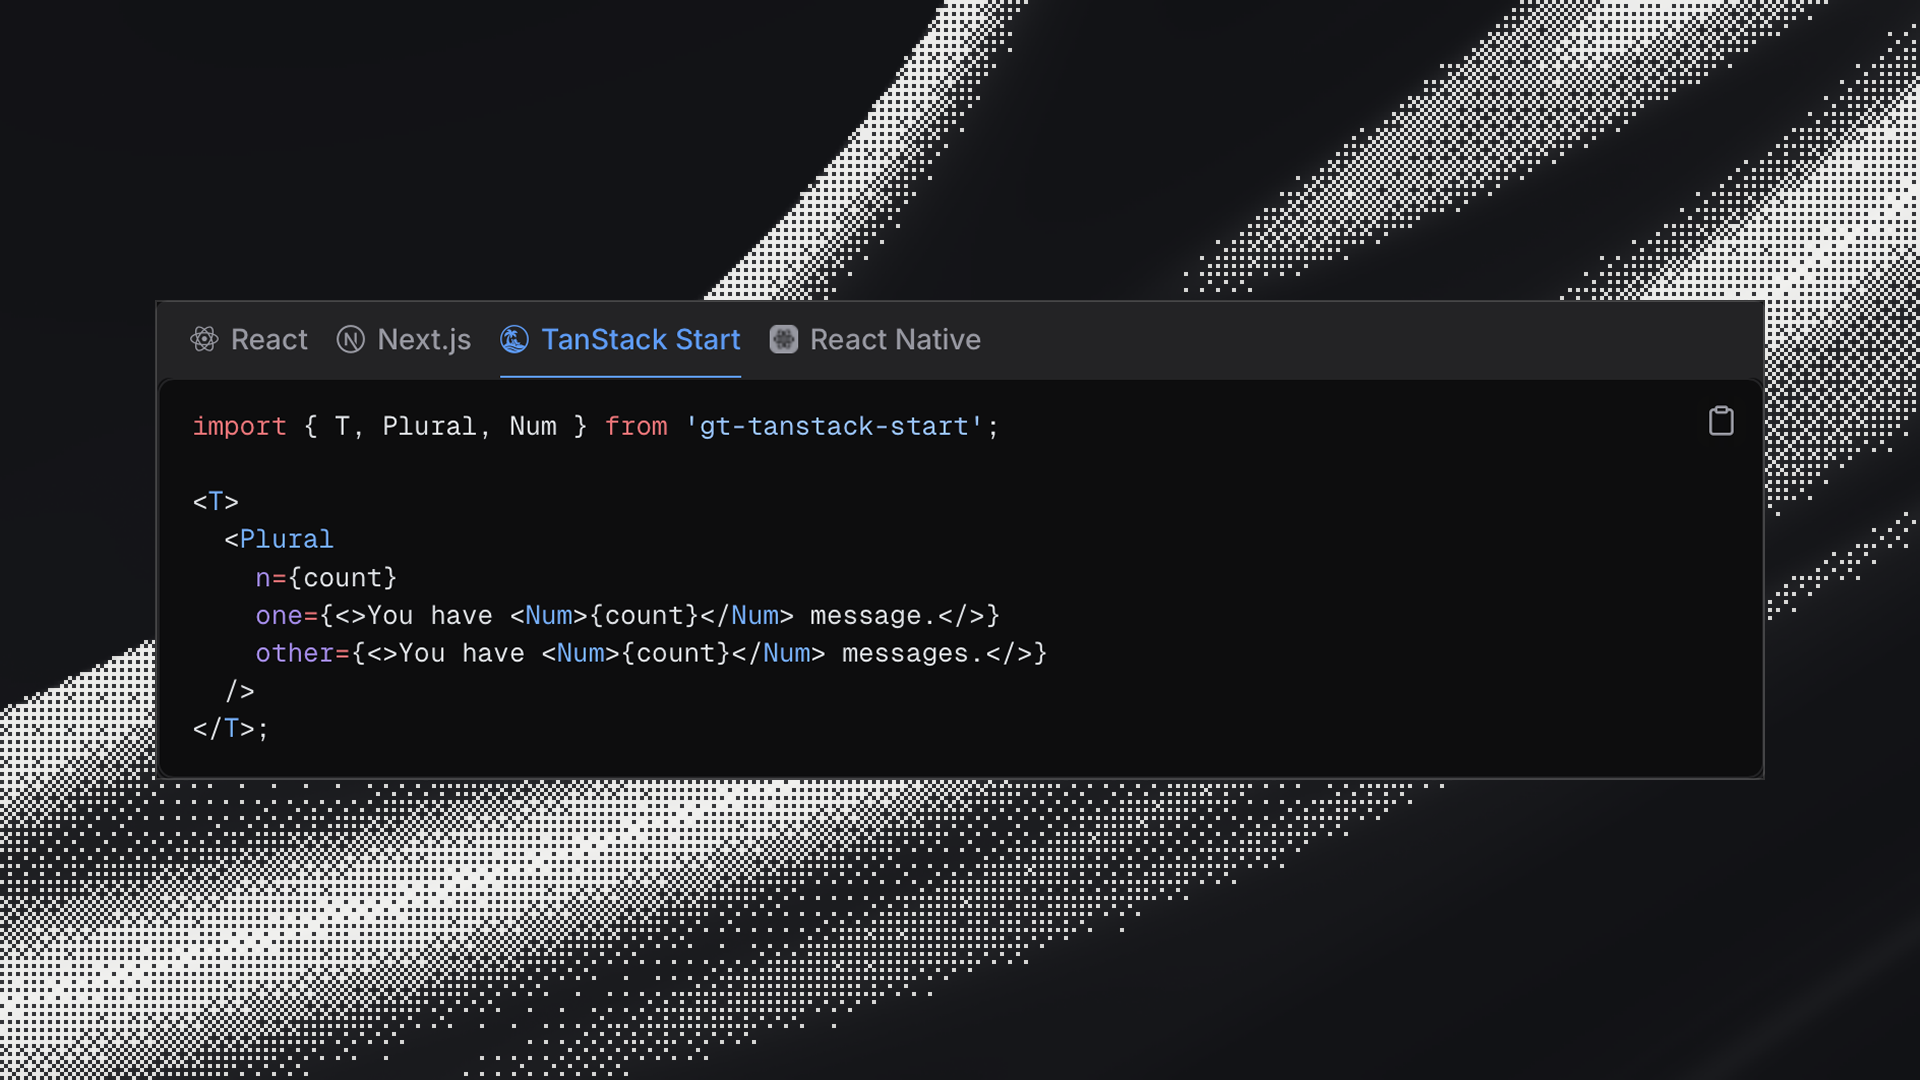
c) 用户选择。 文档站点会记住用户的选择,自动以用户上次选定的语言和主题显示内容。代码块也会自动保留用户所选的框架标签页 (React、Next.js、TanStack Start 或 React Native) 和包管理器标签页 (npm、yarn、bun 或 pnpm) 。
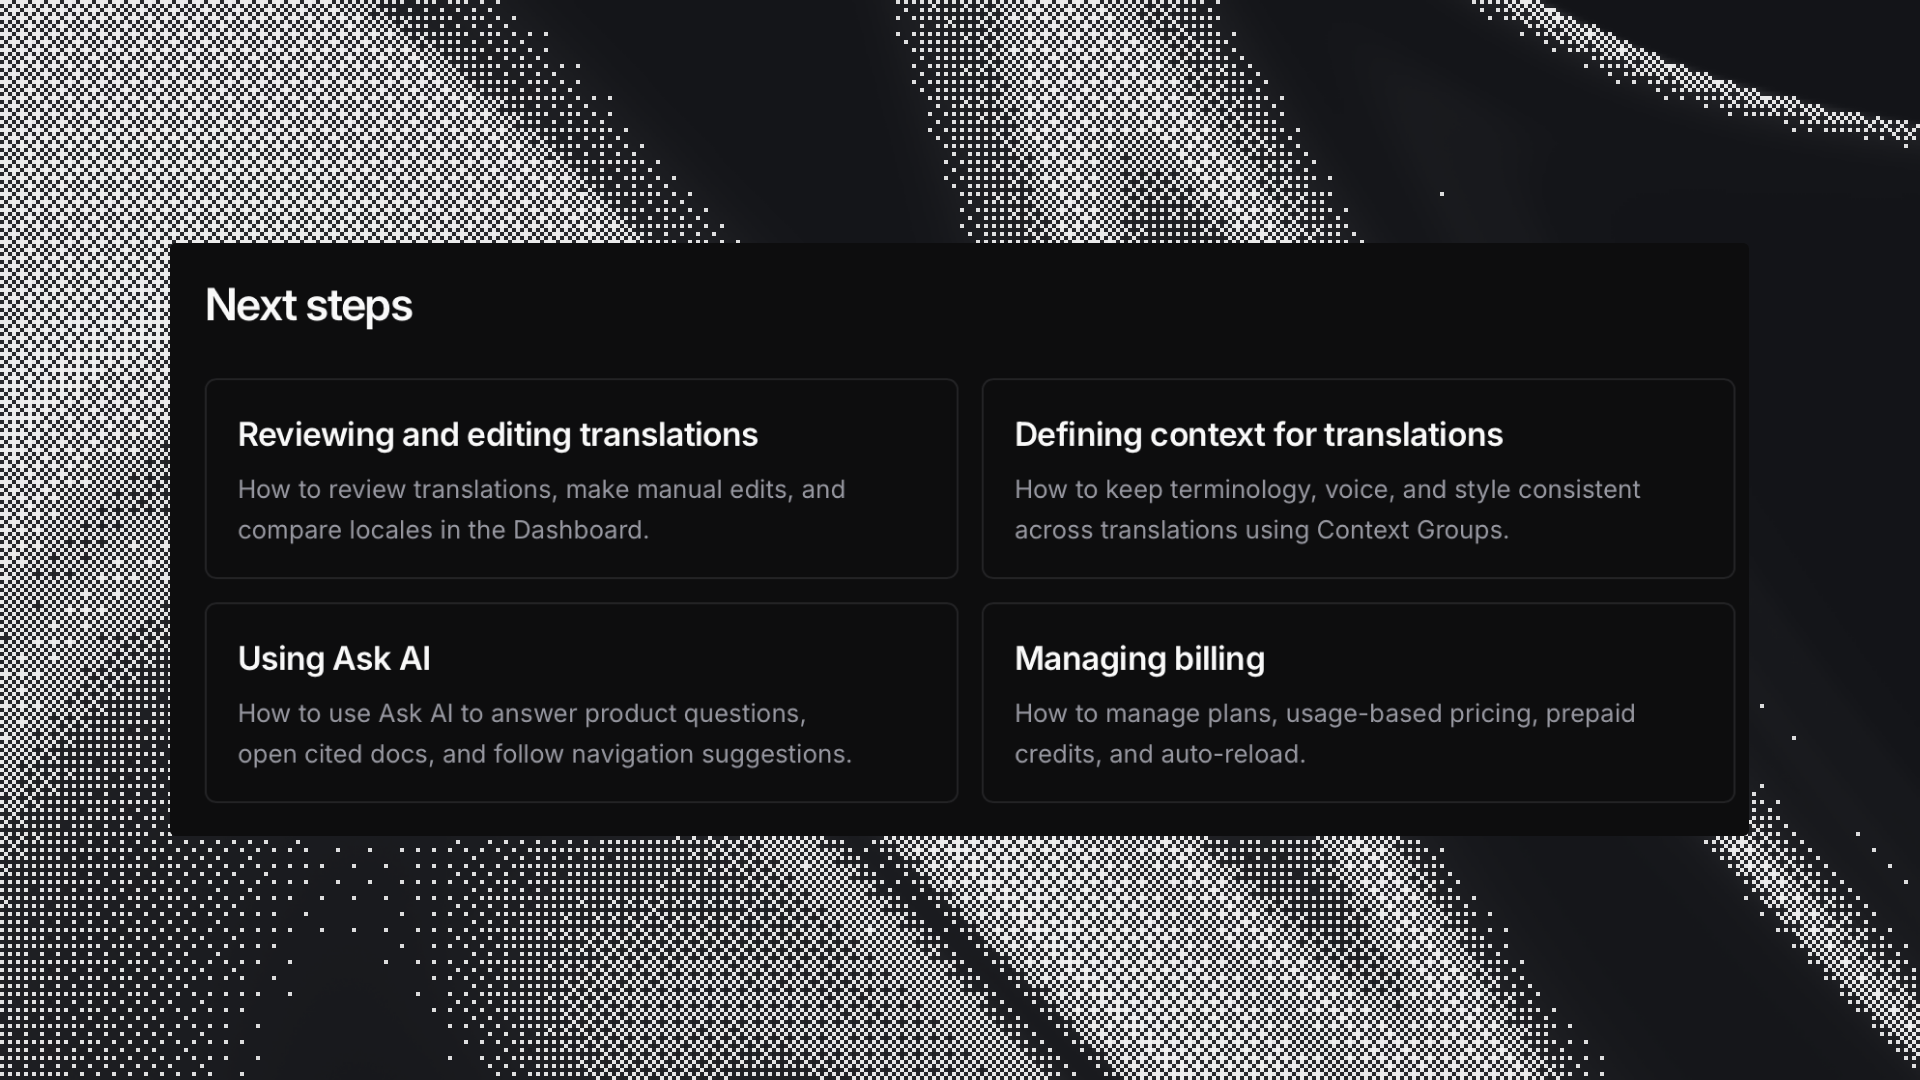
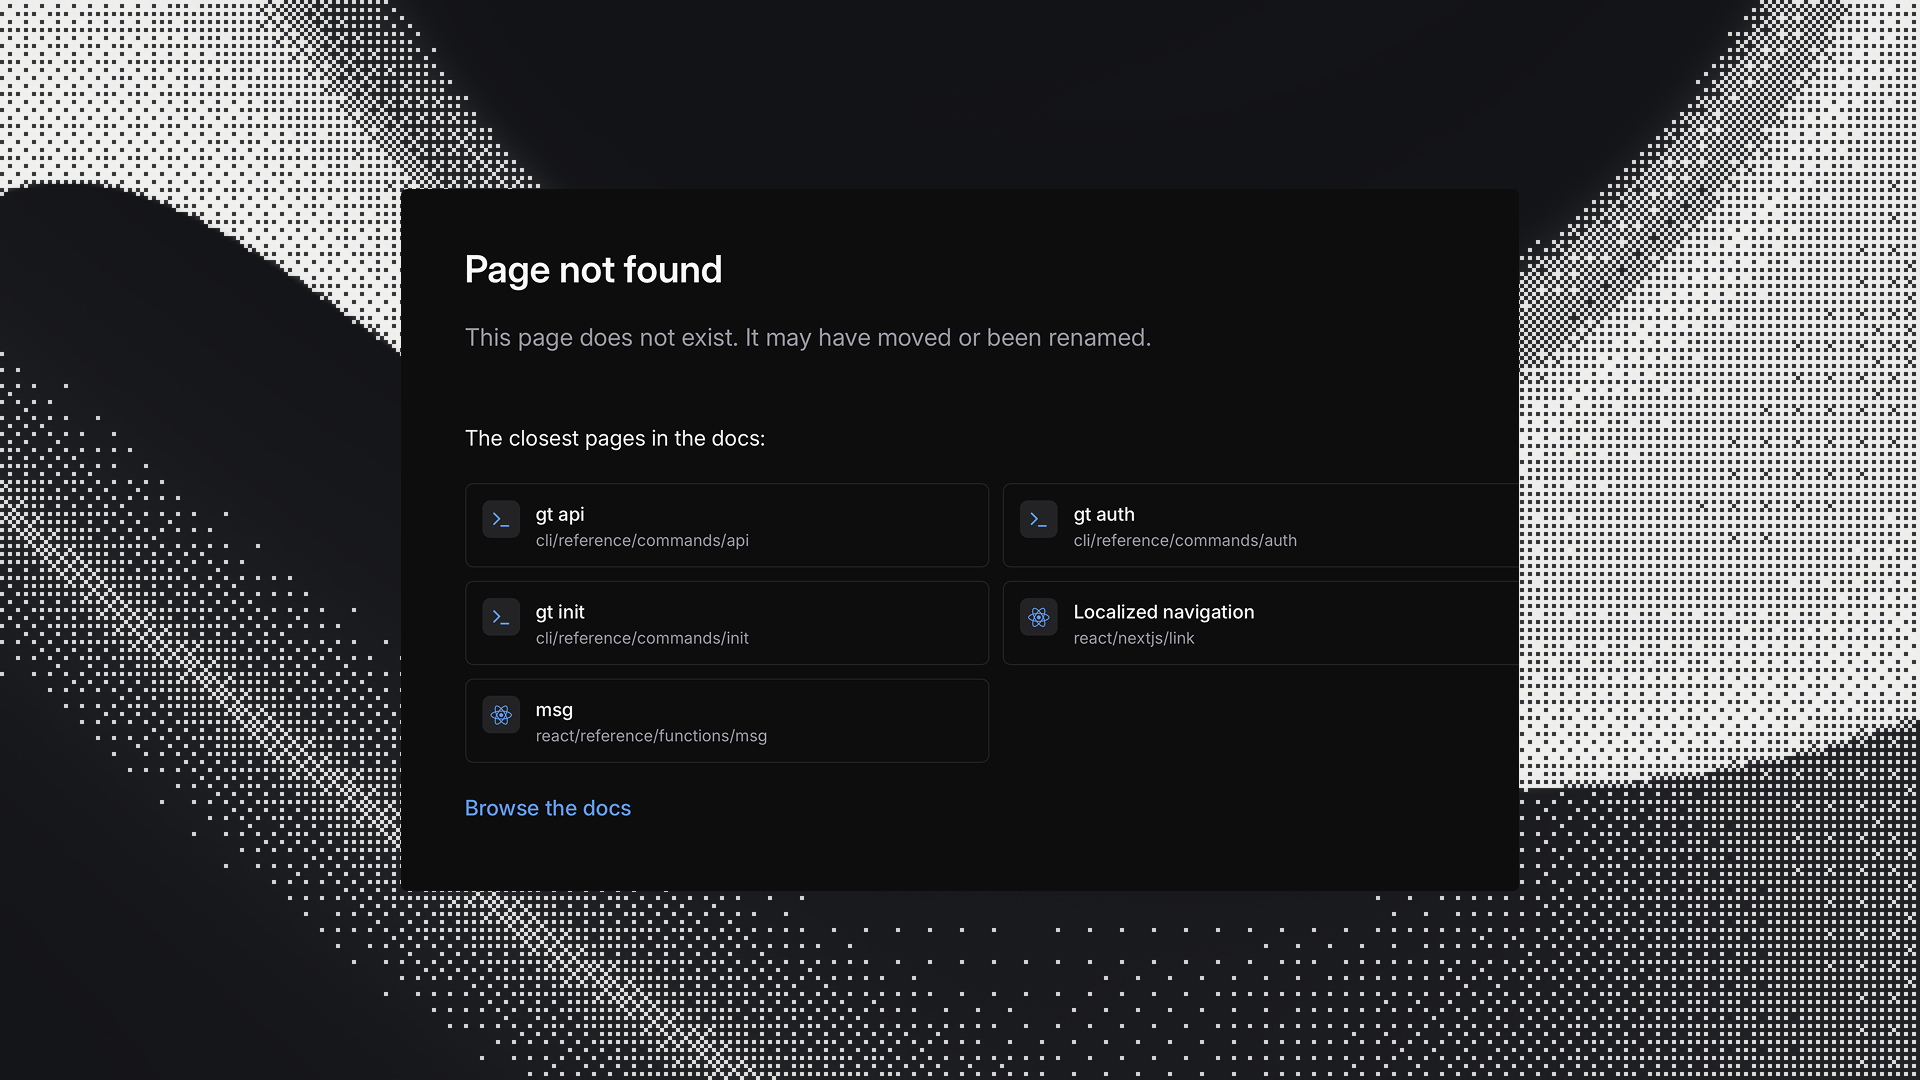
d) 链接路径。 链接路径是另一处小细节:slug 并非直接照搬页面标题,而是在不产生歧义的前提下用词最少的写法。即使措辞或内容发生变化,链接和 heading 锚点也保持不变。我们还内置了一套兜底机制,针对拼写错误的 URL 重定向到最接近的匹配项,或跳转到列出五个最相近页面的专门 404 页面。
简洁的语言
考虑到我们平台上有众多不同的用户群体,文字本身力求简洁清晰。每个页面都会先让读者知道它讲什么、何时该用,再深入讲解工作原理。每个章节也都是一个主题聚焦、自成一体的内容块——事实证明,这样无论对人还是智能体都更易读。
每个页面都面向特定受众并为其量身定制。摘自我们的文档风格指南:
受众
为具体页面的读者而写,并让内容深度和用词与其匹配:
- 技术性、面向开发者的页面。读者是集成 SDK、CLI 或 API 的开发者。对类型、参数、请求头、默认值和错误行为的描述要精确;并给出可运行的示例。同时确保文档对 LLM 和智能体也是机器可读的。
- 非技术性、面向产品的页面:Dashboard 和 Locadex。读者是在 Dashboard UI 中工作的本地化管理者、译者和产品经理。先讲结果和界面操作;用通俗语言解释概念。
适用于所有受众的清晰度规则:
先讲是什么和为什么,再讲怎么做。
一句话只讲一个意思;尽量用短句。
术语首次出现时给出定义,缩写首次使用时写出全称。
不要在介绍之前就使用某个概念、产品术语或设置项。
避免未经解释的行话。如果某个术语无法回避、又复杂到一句话讲不清,请链接到它的定义处。
我们还为特定用户群体专门编写了页面。对于初次接触本地化的用户,Key concepts 页面用浅显的语言讲解了核心概念:国际化、本地化、翻译、locales 和上下文。对于主要使用智能体的用户,Using coding agents 页面会把智能体引导到我们的机器可读文档、MCP 服务器和即插即用的 AGENTS.md 指南 (详见下文) 。
面向智能体阅读的设计
正如多方资料所指出的,如今文档读者中的大多数已是智能体。因此,对 LLMs 友好是我们的头等要务。面向人类和面向智能体的内容在可读性与结构上有许多共通的原则;但智能体还需要专门的发现、检索和工具访问能力。
我们依据 Vercel 的 Agent Readability spec 和 AFdocs spec 来设计智能体就绪能力。这两份规范围绕 AI 智能体如何查找和解析内容提出了几个关键问题:智能体能否发现文档页面、了解其涵盖范围?能否读取干净、可放入上下文窗口的 Markdown 内容?能否搜索、获取并使用正确的 AI 工具?
我们实现中的关键部分包括:
llms.txt:遵循 llmstxt.org 标准的文档索引,并附加了多个层级:llms-index.txt(全部页面) 、llms-scope.txt/<section>(分节索引) ,以及llms-full.txt(完整语料,供可加载更大上下文的工具使用)sitemap.xml和sitemap.md:涵盖每个页面的机器可读地图- 每个页面的原始 Markdown:在任意文档 URL 后追加
.md或.mdx即可。发送Accept: text/markdown的已识别 AI 爬虫和智能体会自动获得 Markdown - 一个 MCP (Model Context Protocol) 服务器:用于本地 stdio 场景的
@generaltranslation/mcpnpm package、位于https://mcp.gtx.dev的托管 endpoint (可流式 HTTP,并提供 SSE 变体) ,以及使用 API Key 认证、限定于项目的 endpointhttps://api.gtx.dev/mcp - 位于
/openapi.json(以及/openapi.yaml) 的机器可读 OpenAPI 规范,并在每个 endpoint 参考页面中给出链接 - 为 RAG (检索增强生成) 而分块组织的内容,每个小节都表达一个完整的意思,并保持一致的 heading 层级
- 宽松的
robots.txt:从不屏蔽 AI 爬虫
流程、维护与风格指南
这次大规模文档重构的落地,是一位人类作者 (也就是我!) 与各种 AI 工具的协作,团队其他成员也提供了不少意见。我们的原则是:靠人的撰写与判断去把握内容、含义与逻辑脉络,把这些心得沉淀成一份严格而全面的风格指南,再借助 AI 把风格指南规模化,并与代码库的更新保持同步。
我首先做了一次全面的盘点,整理出覆盖 900 个页面、117,000 多字正文的现有文档清单。有了这份原始素材的索引,我便依照一份手绘的结构图重构内容:需要哪些高层分区、各框架该如何分组与排序,以及每个页面的用途。我在每个分区中撰写并打磨了具有代表性的页面,把清晰、简洁、服务于用户旅程的理念落到实处。手写的这部分花了一个多月的专注投入。其中快速入门尤其需要大量测试,我们的 i18n library 工程师也做了不少修改。
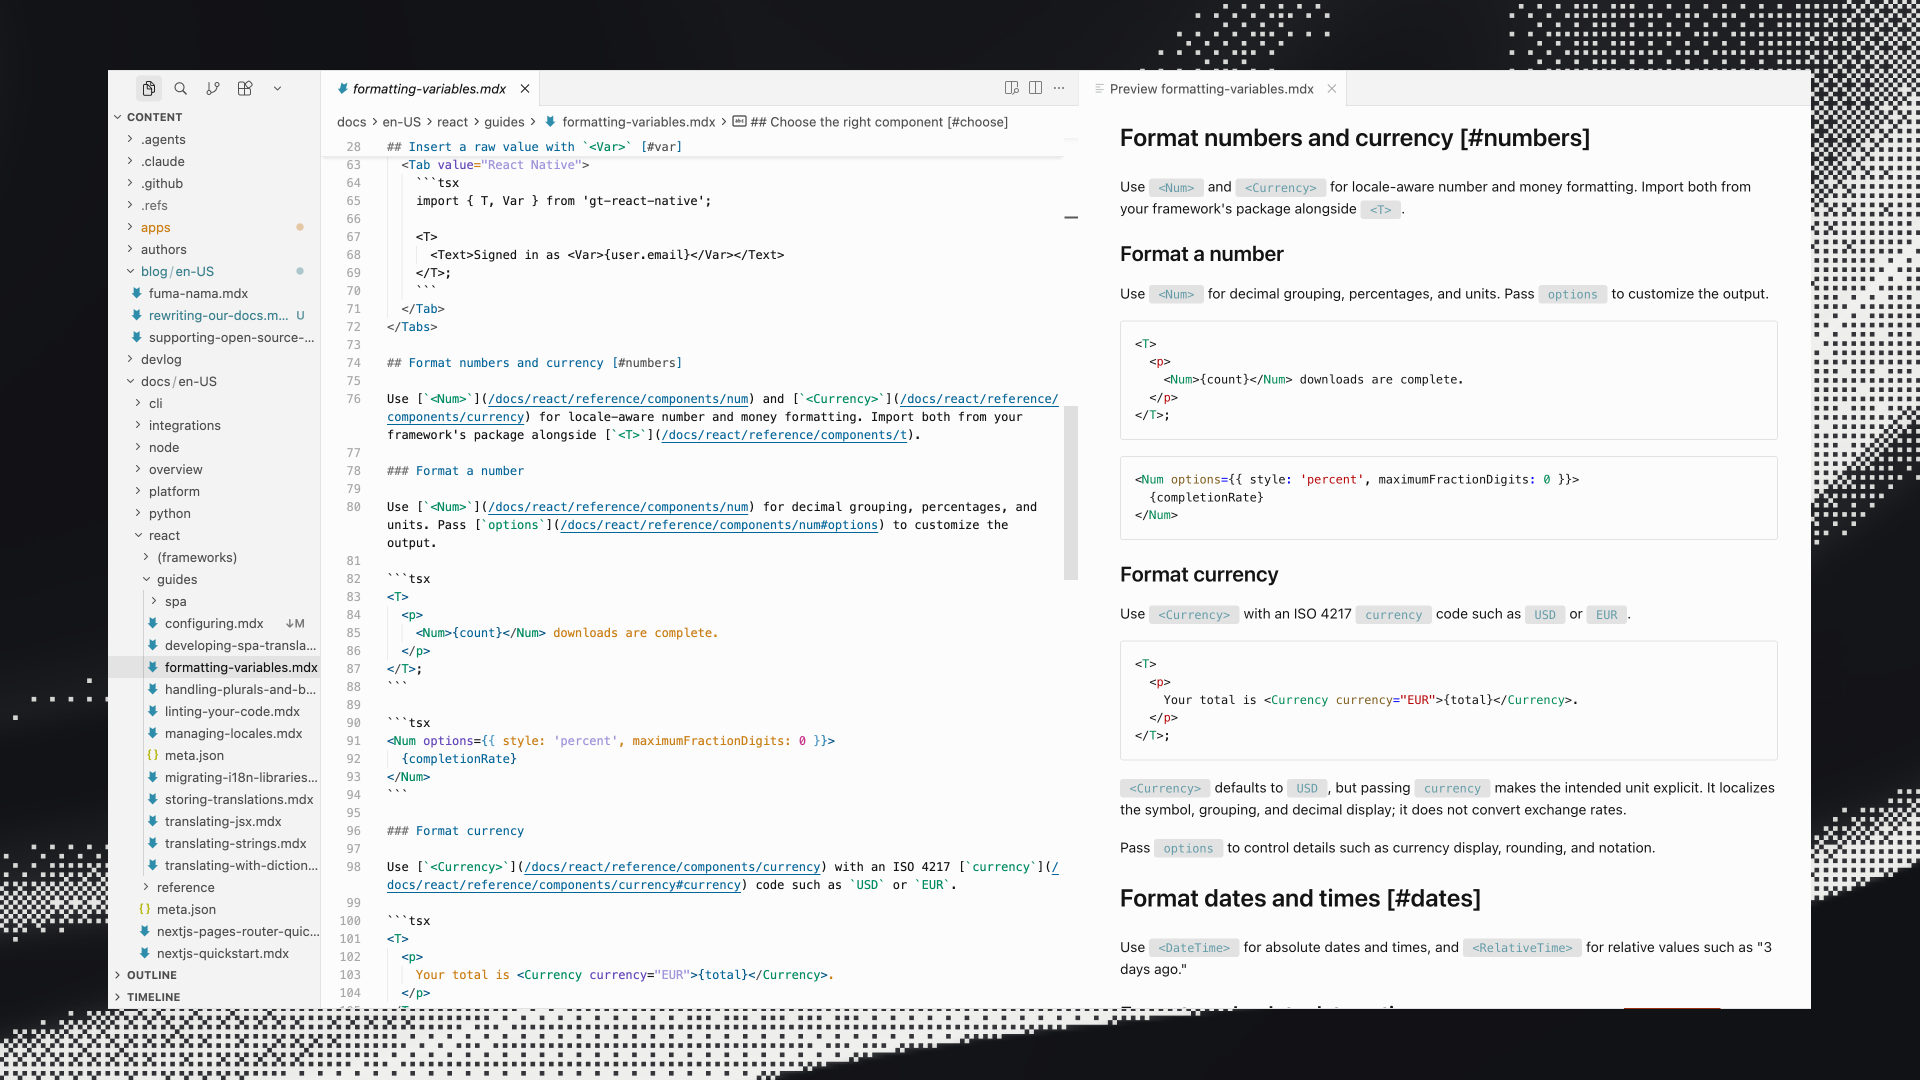
这个过程中特别有意思的一点,是直接在 Cursor 里写作,并充分利用 Markdown 预览面板。这样一来,我的每一处改动都被版本历史完整记录下来,我就可以轻松地让智能体**把我的改动 (甚至思考过程) 归纳成准则与规则,写进文档风格指南,并应用到每一个页面上。**此后每次修改文档,无论是结构还是内容,我们都会这样归纳并通过风格指南落实下去。
正因如此,我们的文档风格指南极为详尽,完全贴合我们对文档的具体偏好,涵盖各类边界情况与用户目标,篇幅超过 830 行、13,000 字。这份风格指南是一套操作规程,在 CI 中强制执行,也便于智能体直接应用,既包含宏观的写作原则,也包含非常具体的规则与技巧。**此外还有一个云端智能体每天运行,让文档与已上线的行为保持同步。**它会排查覆盖缺口、不准确之处和过时示例,会新建一个项目在本地测试功能,还会按照风格指南对文稿进行检查。
这些风格指南规则,与我们为保障客户翻译质量而实施的上下文与自定义提示规则颇为相似。
第二部分:视觉设计
我们希望这些结构调整让文档变得更直观、更好用。也欢迎你随时提出反馈:每个文档页面都提供了相应按钮,可用于编辑页面、报告问题或提问。
敬请期待博客的第二部分,我们将介绍文档的 UI 与交互重新设计,以及我们如何基于 Fumadocs 打造自定义视觉效果。