Taylor Fang

Concevoir pour une double expérience de lecture
La documentation présente un produit et son architecture. Elle doit aider l'utilisateur à se construire un modèle mental du produit et de son fonctionnement, en le guidant dans un parcours intuitif et en répondant à ses questions chemin faisant. Elle doit simplifier les concepts pour les nouveaux utilisateurs et en dévoiler la complexité à mesure qu'ils progressent.
Mais il y a désormais un nouveau lecteur. Les agents supplantent rapidement les utilisateurs humains en tant que lecteurs de premier plan, et ils ont besoin d'une architecture spécialisée pour découvrir, lire et analyser la documentation.
Notre documentation s'est développée de façon organique à mesure que notre plateforme prenait en charge de nouveaux frameworks et de nouvelles intégrations. Mais la structure, l'ordonnancement et la langue ont commencé à dériver.
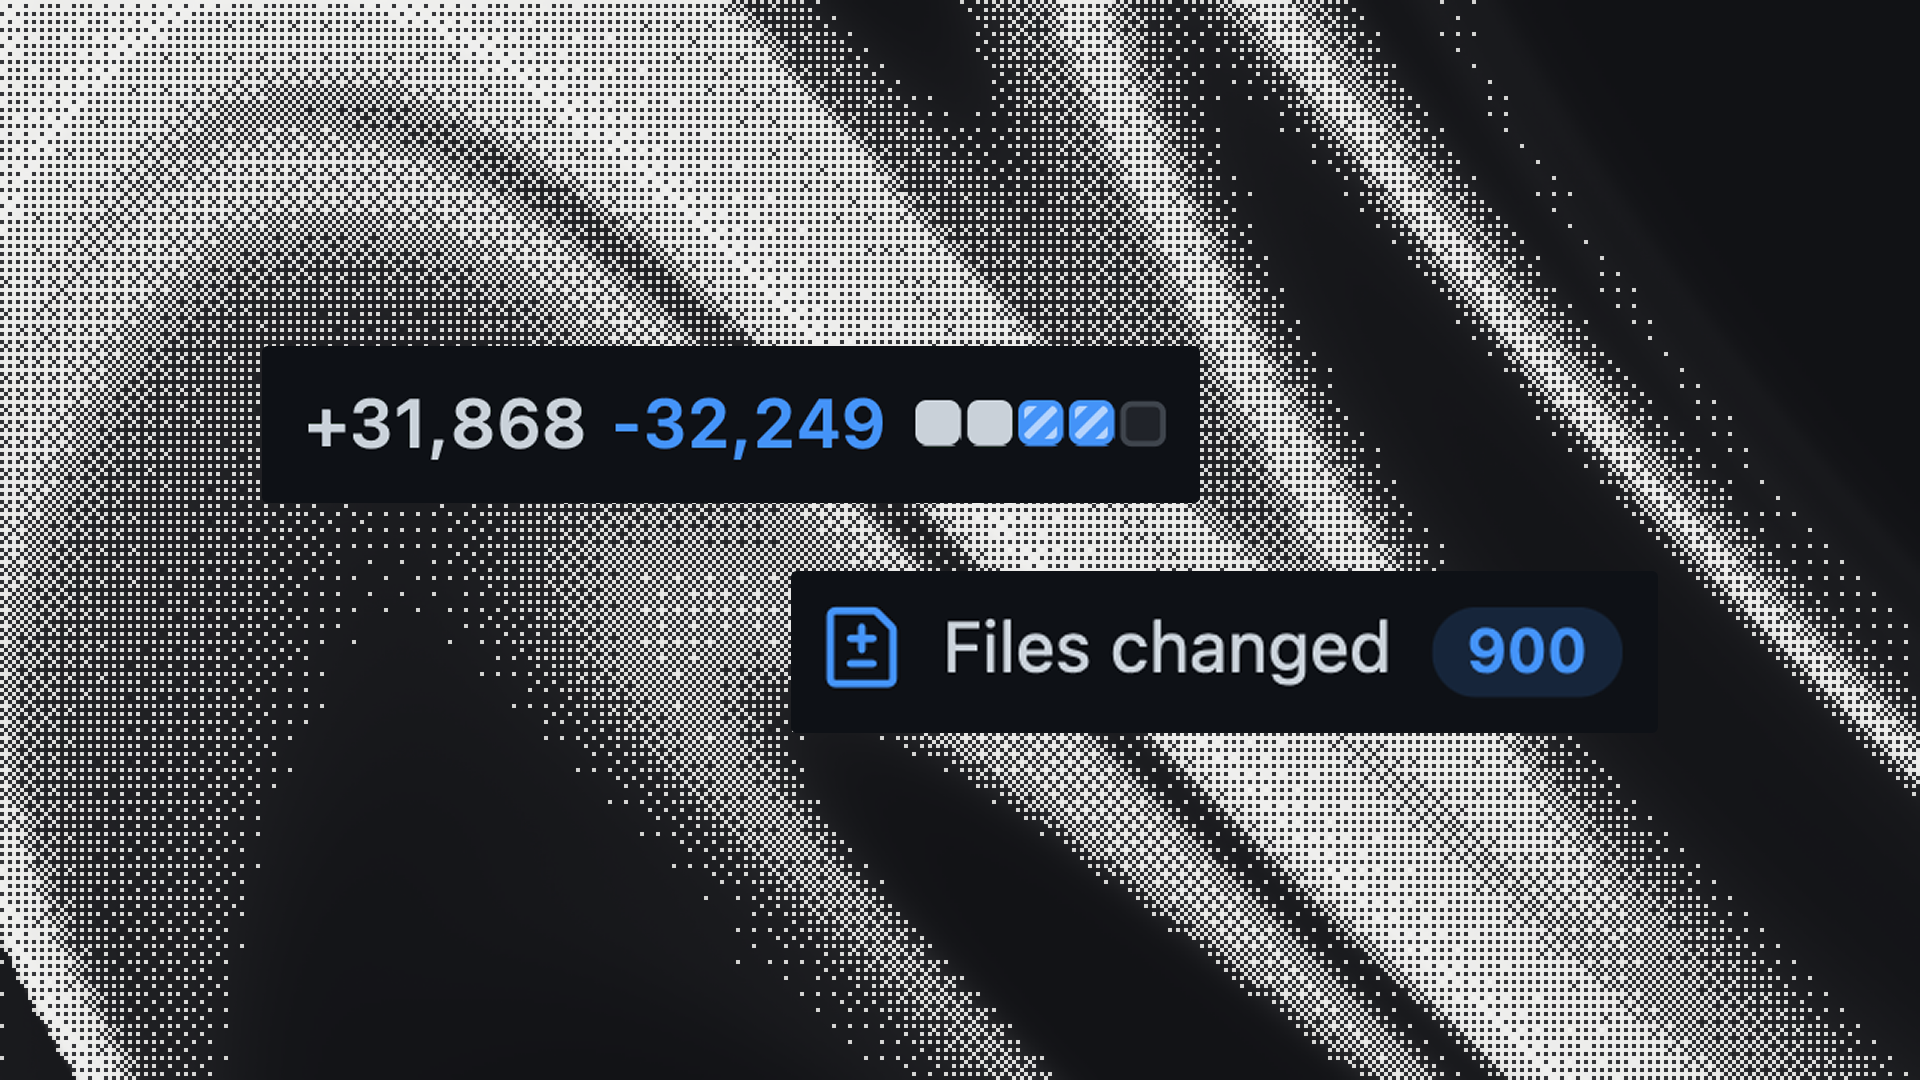
Nous avons décidé de la reconstruire entièrement, avec une attention toute particulière portée à l'expérience de lecture, tant pour les humains que pour les agents. La refonte initiale a touché 900 fichiers (+31 868 / −32 249 lignes). Nous avons rédigé un guide de style de 13 000 mots, avec des règles relatives au public, à l'anatomie des pages, au style et à la grammaire. La documentation est désormais maintenue par un agent cloud quotidien qui la passe au lint selon ce guide de style.
Pour la lisibilité par les agents, nous servons également llms.txt et llms-full.txt afin d'indexer le site, et chaque page de documentation est servie en Markdown brut en ajoutant .md à son URL. Nous proposons une page de documentation pour les agents de codage avec un fichier AGENTS.md prêt à l'emploi qui explique à un agent comment configurer, utiliser et traduire correctement, aux côtés de notre MCP server et de notre spécification OpenAPI lisible par machine.
Cet article revient sur les changements que nous avons opérés et les enseignements que nous en avons tirés.
Inspirations
Nous nous sommes documentés et avons puisé notre inspiration dans les bonnes pratiques et les documentations pour développeurs que nous admirons :
- Les écrits de Lee Robinson sur la documentation. « Gardez la première expérience simple et dévoilez la complexité progressivement. » Ses dix principes sont notamment : rapide, lisible, AI-native, soignée, adaptative. Et localisée, bien sûr. (Nous avons d'ailleurs collaboré avec Lee pour localiser la documentation de Cursor !)
- Les écrits de Fuma Nama sur la documentation. Il recommande un style d'écriture simple et préconise de construire une structure plus logique à l'aide de gras, de titres, d'hyperliens, de listes et de tableaux. Fuma soutient également que la navigation peut compter davantage que le contenu pour l'expérience du lecteur. (En savoir plus sur la philosophie de Fuma dans notre entretien.)
- Les écrits de Devin Logan sur la documentation prête pour les agents. Devin explique que la nouvelle norme, c'est que les utilisateurs accèdent à la documentation via des agents. Elle détaille les étapes à suivre pour une bonne lisibilité par l'IA : côté contenu, celui-ci doit expliquer les systèmes et proposer des étapes exécutables ; côté plateforme, les pages doivent être faciles à trouver et allégées pour les agents.
- Nous avons examiné de près les documentations pour développeurs que nous aimons : Linear pour sa clarté et sa simplicité, Replicate pour sa navigation hiérarchique limpide, shadcn/ui pour la beauté de son design, Next.js pour son langage adapté aux développeurs et ses fonctionnalités communautaires, Convex pour ses visuels réjouissants, Stripe pour ses fonctionnalités intégrées, et bien d'autres encore.
Parcours utilisateur
Nous avons restructuré les pages et le vocabulaire autour de ce que l'utilisateur cherche à accomplir, plutôt que de simplement décrire des fonctionnalités techniques. Chaque section suit la même ossature : Quickstart, Guide et Reference.
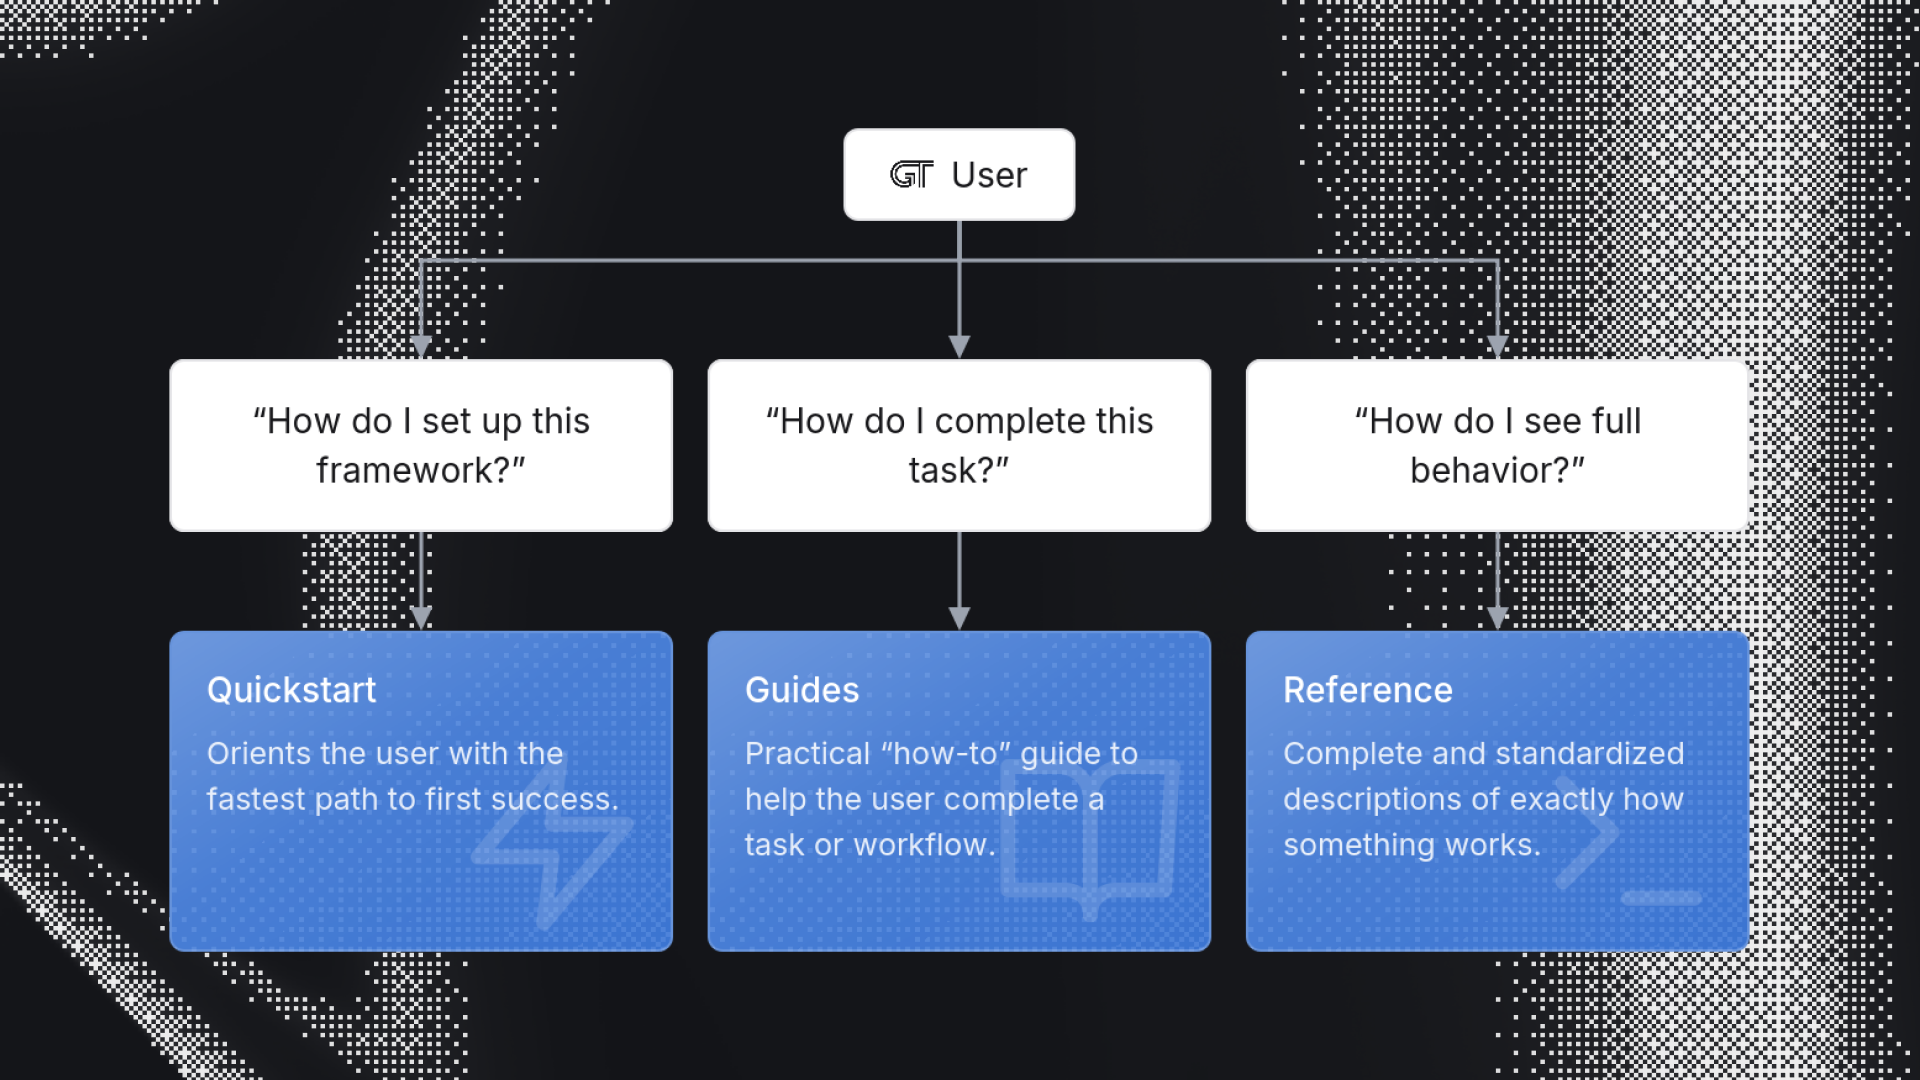
Les guides sont intitulés sous forme de gérondifs et de tâches à accomplir, comme « Réviser et modifier les traductions » ou « Gérer les pluriels et les branches ». Un nouvel utilisateur qui cherche à mener à bien un workflow n'a pas besoin de deviner quel terme de référence rechercher : il lui suffit de rechercher l'action qu'il souhaite effectuer.
Effet secondaire appréciable : nos guides se classent eux-mêmes très bien en SEO, jusqu'à figurer en tête des résultats Google pour des recherches comme « React managing locales », « React translating jsx », « Configuring a Vite SPA i18n », « React plurals and branches », « Translating rrweb », et bien d'autres.
Le site de documentation lui-même repose sur Fumadocs, dont nous avons récemment interviewé le créateur au sujet de sa vision d'une expérience de lecture élégante et composable.
Un parcours logique et intuitif
La documentation doit aider l'utilisateur à se construire un modèle mental du produit et de son fonctionnement. Dans cette optique, un parcours intuitif est essentiel, aussi bien dans la navigation que sur chaque page. L'ordre doit être réfléchi et porteur de sens, avec un regroupement logique et un enchaînement correspondant à l'ordre dans lequel un lecteur est susceptible d'agir. L'objectif est d'épouser la courbe d'apprentissage, afin que les débutants puissent facilement se construire le bon contexte, la complexité et la personnalisation se dévoilant à mesure qu'ils lisent et approfondissent. Un parcours intuitif doit passer inaperçu.
a) Structure. La structure et l'ordre de notre documentation sont vérifiés en CI, avec un contrôle qui fige les sections de premier niveau afin qu'une nouvelle page vienne s'insérer dans l'architecture de l'information existante.
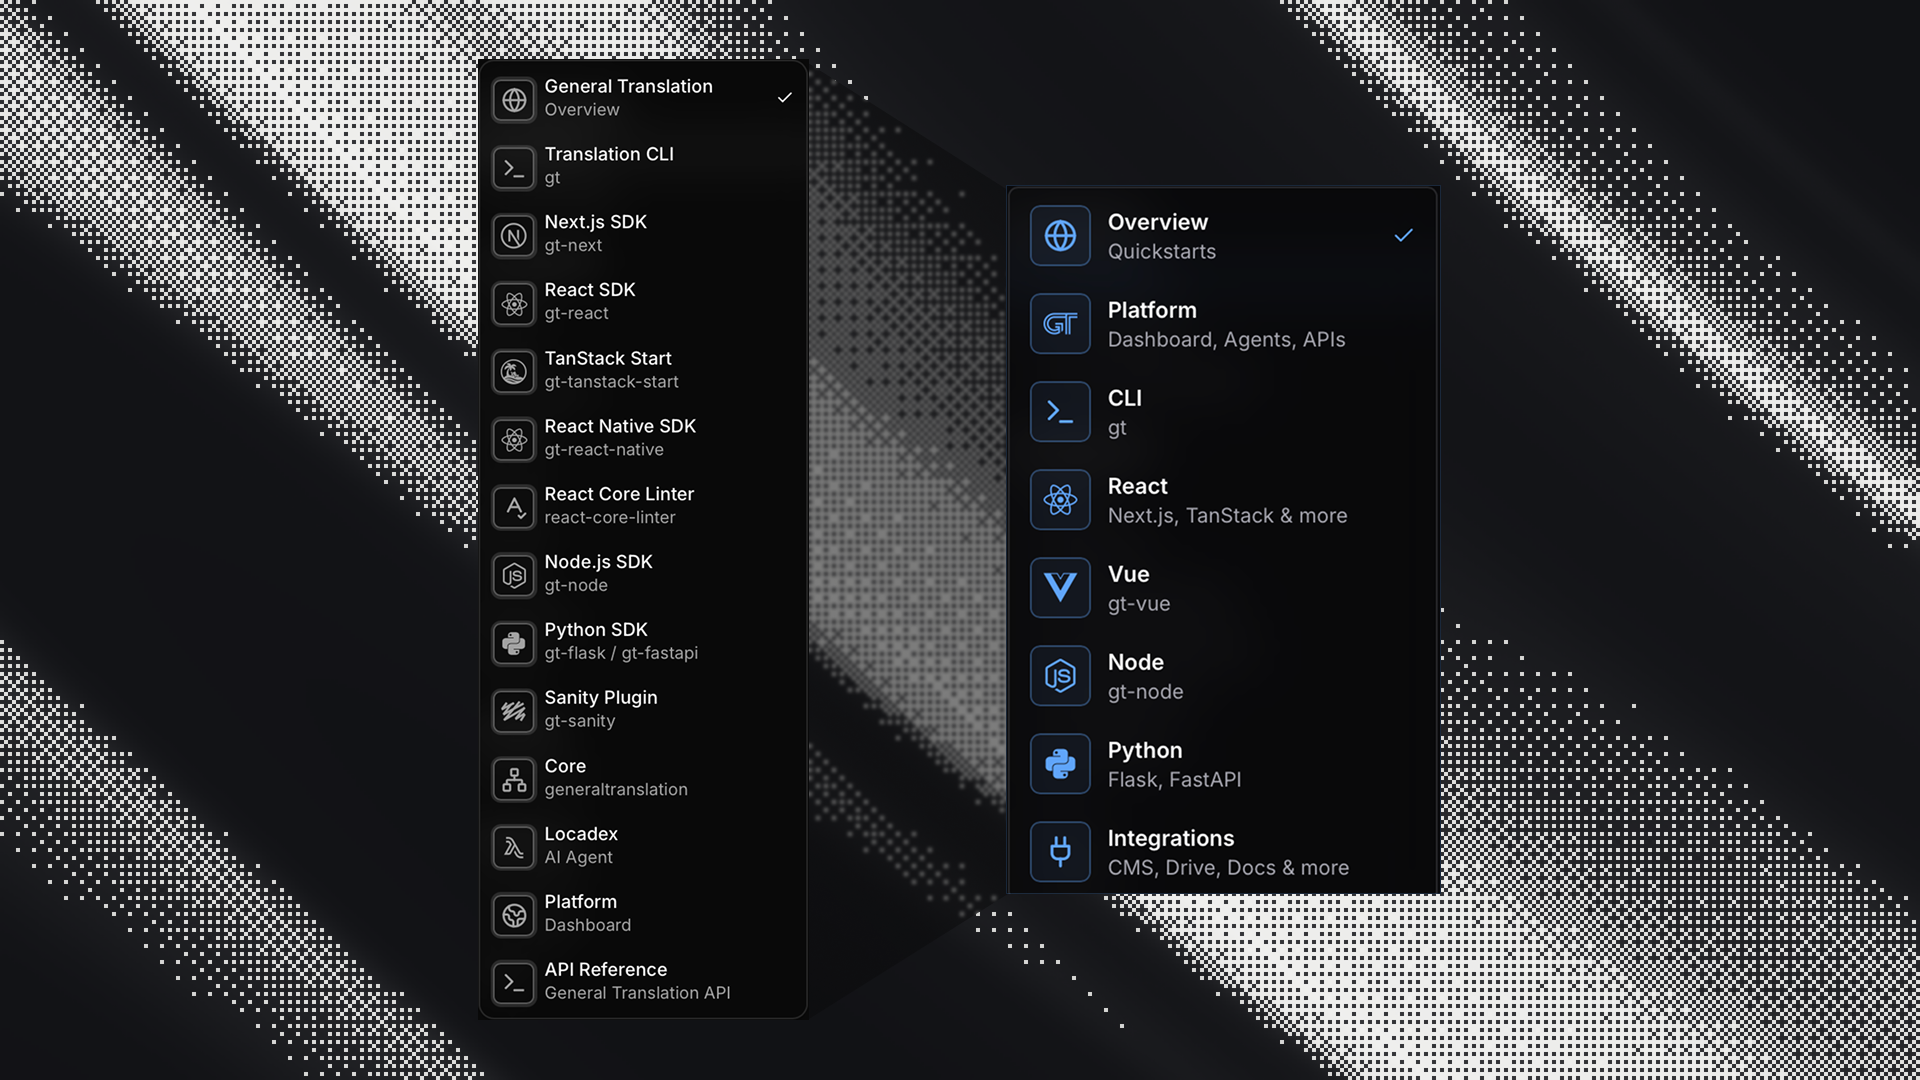
b) Pages associées. Chaque page oriente les utilisateurs vers les étapes suivantes, avec des liens connexes mis à jour selon leur proximité logique. Le Quickstart mène aux quatre pages de Guide les plus consultées, et chaque page de Guide mène à des Guides ou des Références associés. Les liens figurent dans le frontmatter plutôt que dans le corps du texte, afin que le build puisse vérifier les cibles par rapport à l'arborescence des pages.
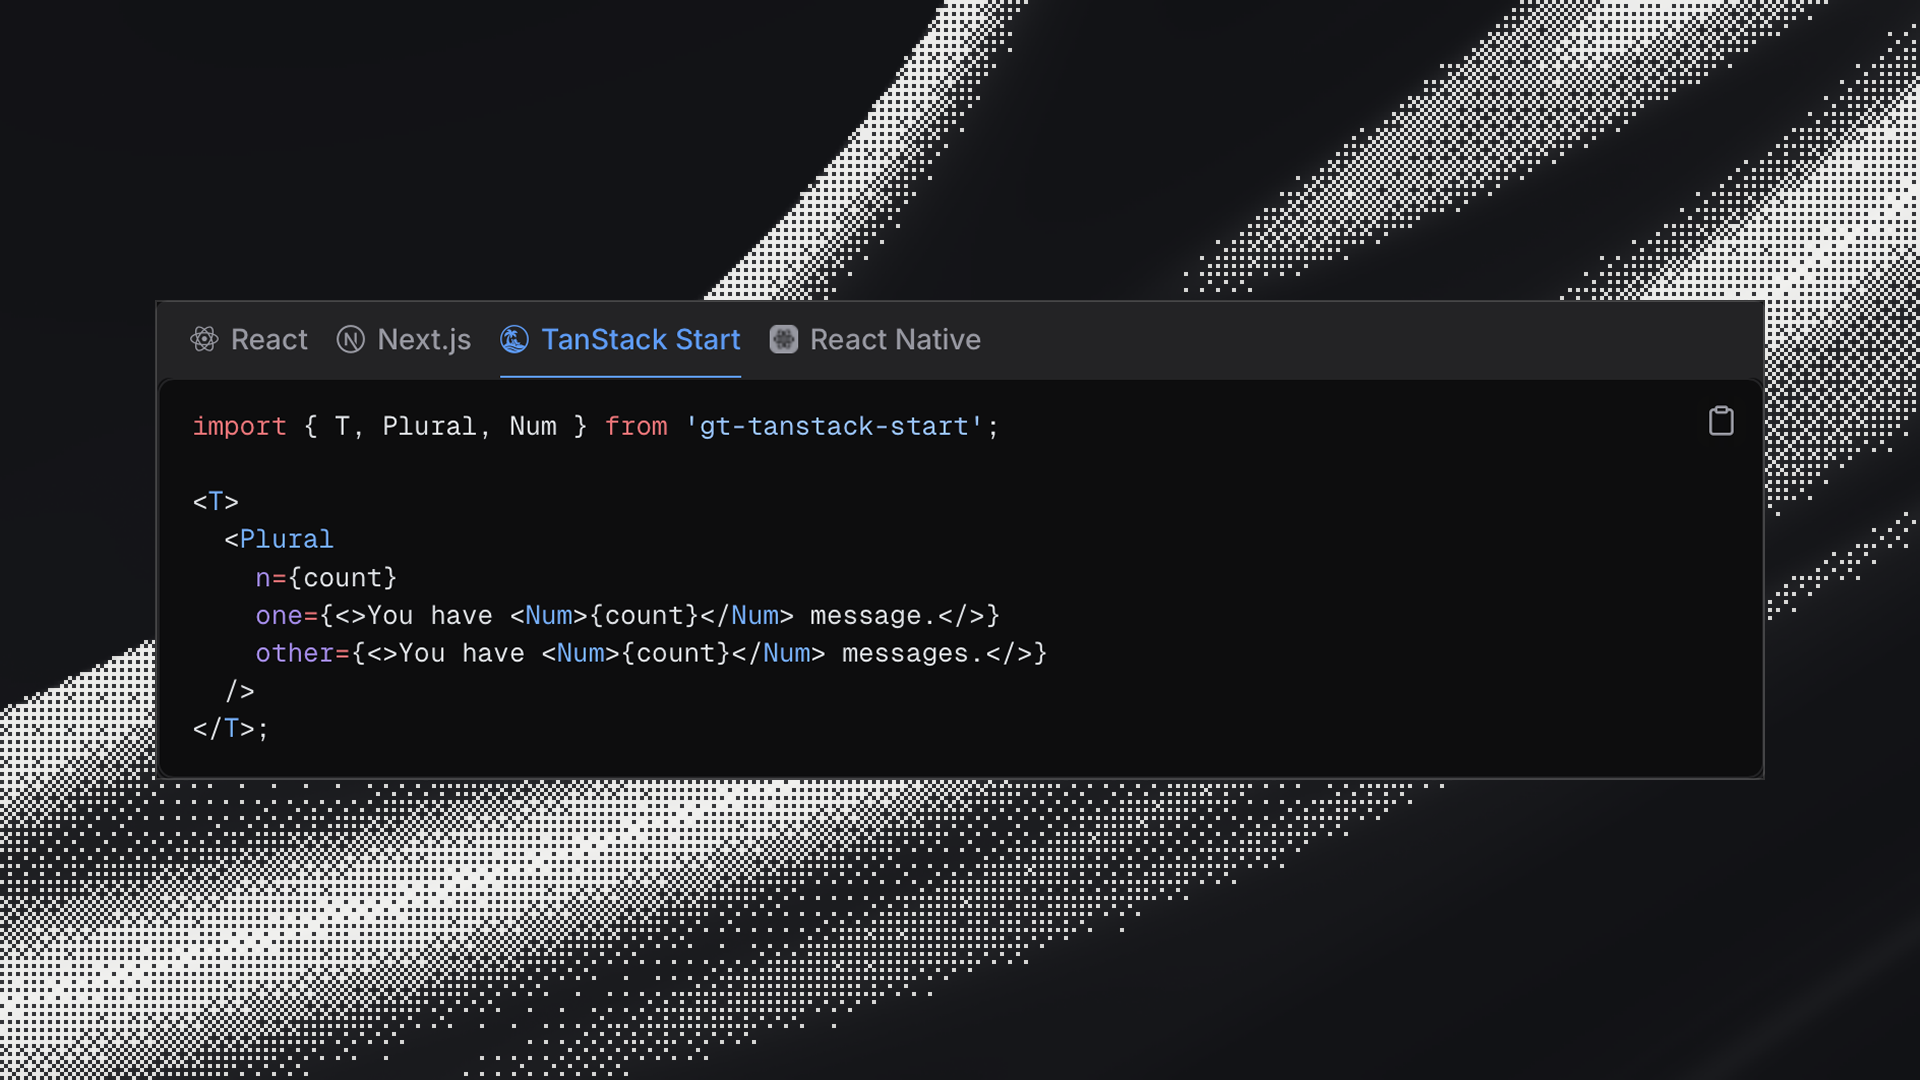
c) Choix de l'utilisateur. Le site de documentation mémorise les choix de l'utilisateur et affiche automatiquement le contenu dans la dernière langue et le dernier thème sélectionnés. Les code blocks préservent également de façon automatique l'onglet choisi par l'utilisateur pour le framework (React, Next.js, TanStack Start ou React Native) et le package manager (npm, yarn, bun ou pnpm).
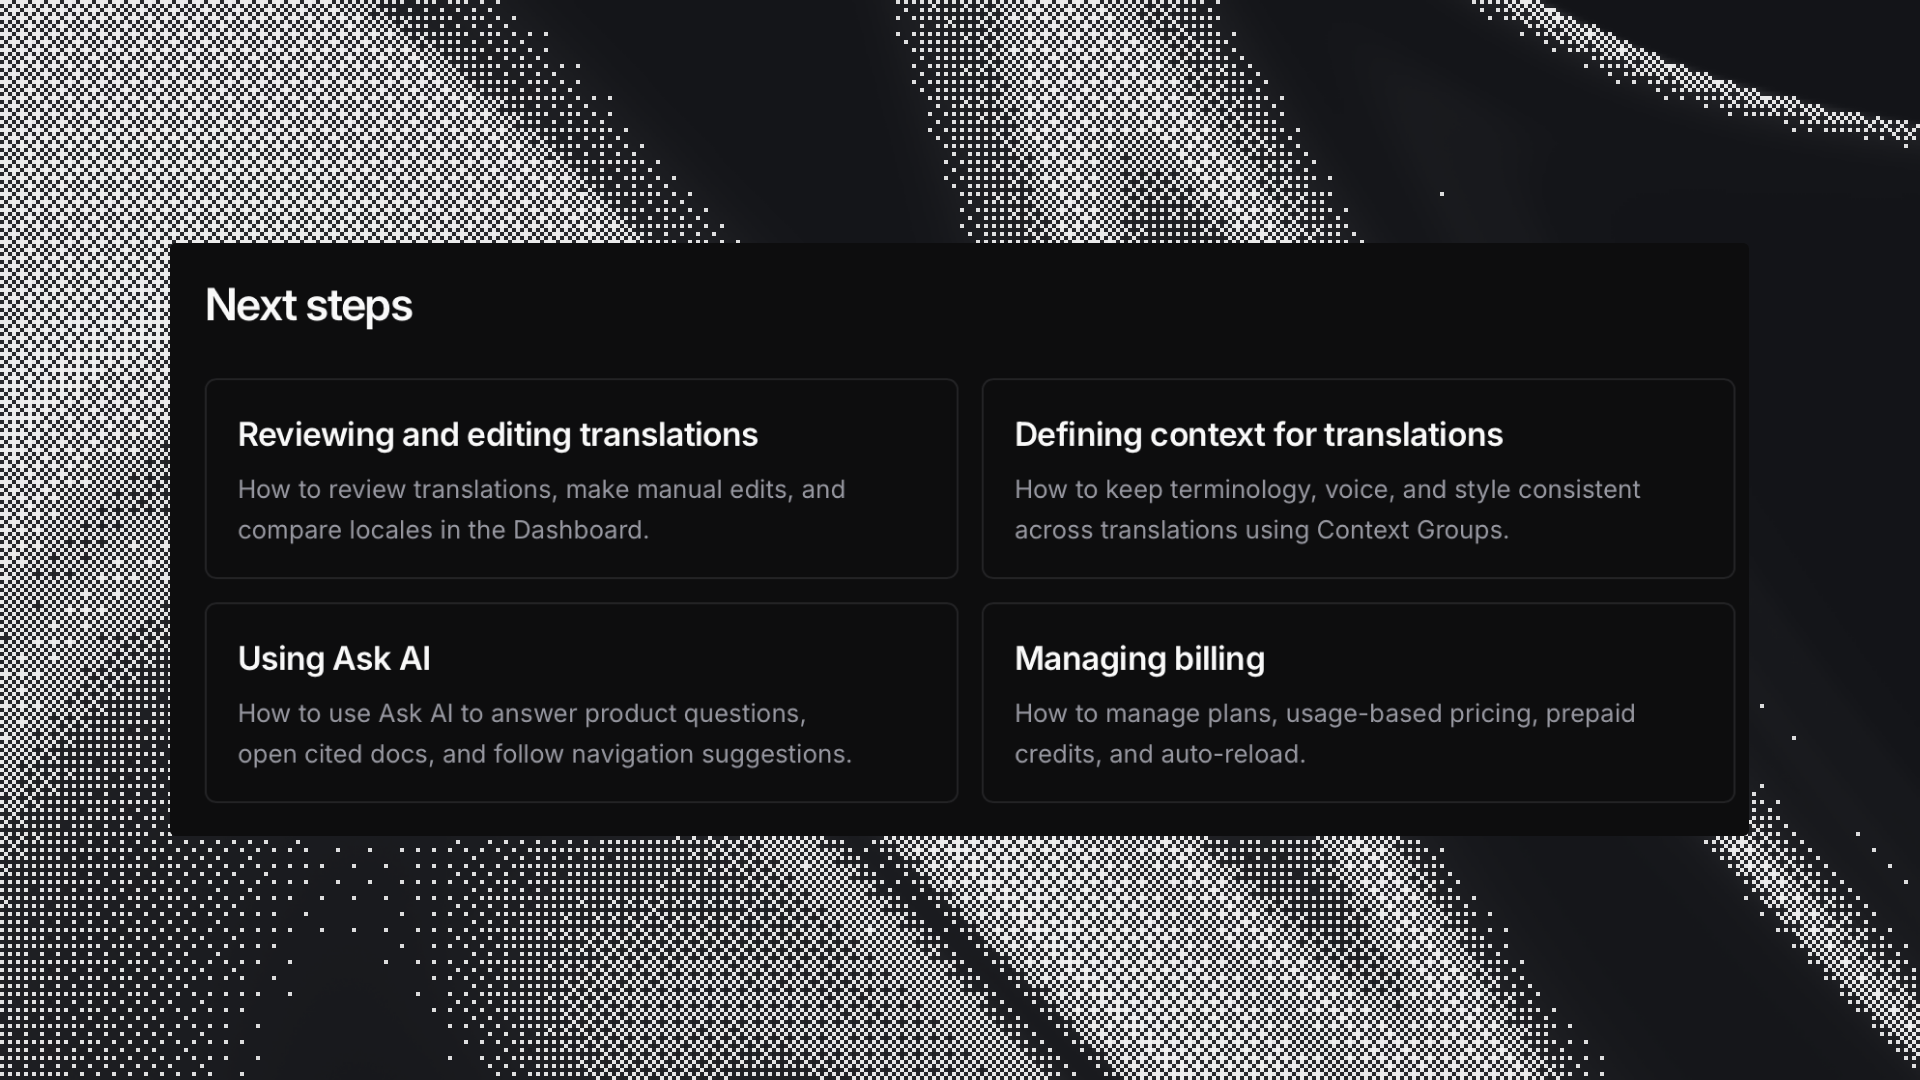
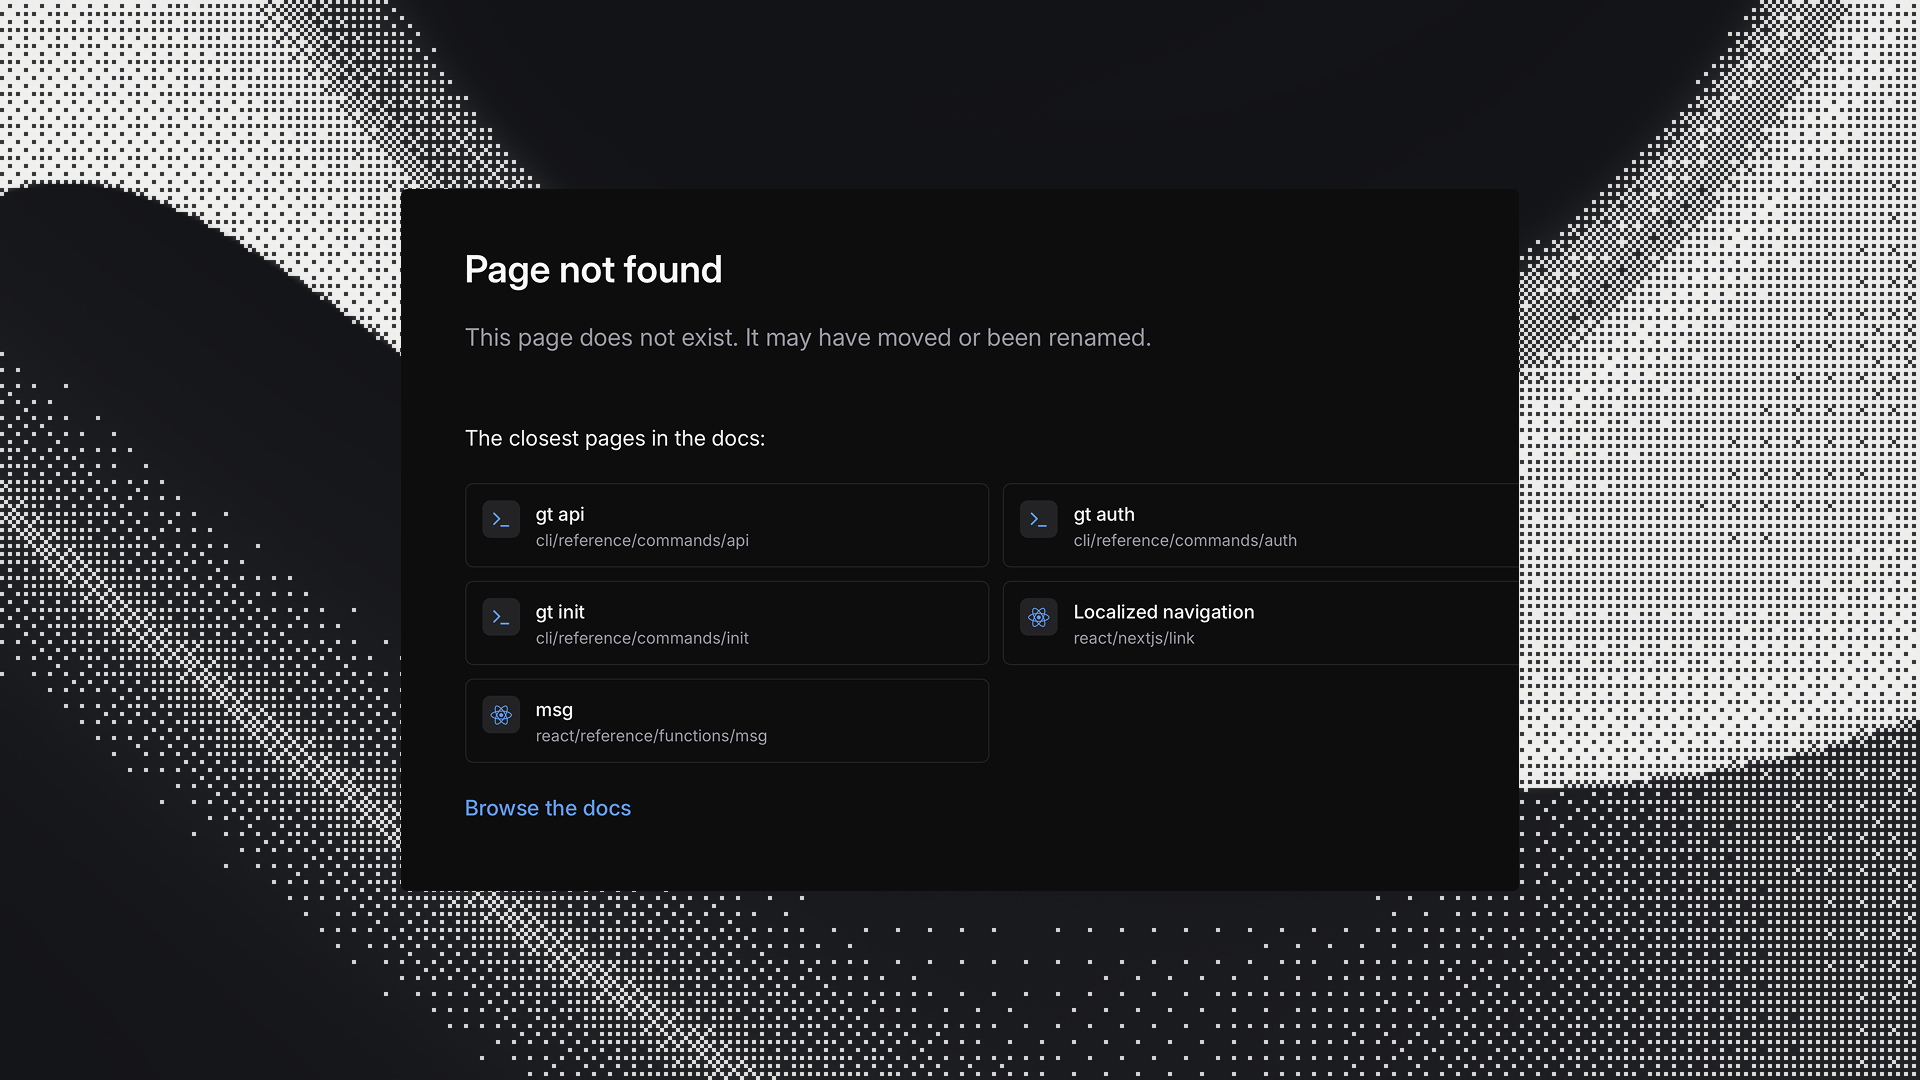
d) Chemins des liens. Les chemins de nos liens sont un autre petit détail : les slugs ne reprennent pas simplement le titre de la page, mais se limitent au plus petit nombre de mots permettant de rester sans ambiguïté. Les liens et les ancres de heading restent identiques même si la formulation ou le contenu change. Nous avons aussi mis en place un système de rattrapage pour les URL mal orthographiées, qui redirige vers la correspondance la plus proche ou vers une page 404 spéciale présentant les cinq pages les plus proches.
Langage simple
Compte tenu de la diversité des profils d'utilisateurs sur notre plateforme, le langage lui-même privilégie la simplicité et la clarté. Chaque page indique d'abord au lecteur ce qu'elle couvre et quand s'en servir, avant d'entrer dans le détail de son fonctionnement. Chaque section forme par ailleurs un bloc ciblé et autonome, ce qui se révèle plus facile à lire aussi bien pour les humains que pour les agents.
Chaque page s'adresse à un public précis et est adaptée à celui-ci. Extrait de notre guide de style de documentation :
Public
Écrivez pour le lecteur de la page concernée, et adaptez-lui le niveau de détail et le vocabulaire :
- Pages techniques, destinées aux développeurs. Les lecteurs sont des développeurs qui intègrent le SDK, le CLI ou l'API. Soyez précis sur les types, les paramètres, les headers, les valeurs par défaut et le comportement en cas d'erreur ; proposez des exemples exécutables. Veillez à ce que la documentation soit également lisible par machine pour les LLMs et les agents.
- Pages non techniques, orientées produit : Dashboard et Locadex. Les lecteurs sont des responsables de localization, des traducteurs et des chefs de projet qui travaillent dans l'UI du Dashboard. Commencez par les résultats et les actions dans l'UI ; expliquez les concepts en langage clair.
Règles de clarté valables pour tous les publics :
Commencez par le quoi et le pourquoi avant le comment.
Une idée par phrase ; privilégiez les phrases courtes.
Définissez un terme dès sa première apparition, et développez les acronymes à leur première utilisation.
N'employez pas un concept, un terme produit ou un réglage avant de l'avoir présenté.
Évitez le jargon non expliqué. Si un terme est incontournable et trop complexe pour être expliqué en une phrase, renvoyez par un lien vers l'endroit où il est défini.
Nous avons également rédigé des pages pour des profils d'utilisateurs spécifiques. Pour ceux qui découvrent la localization, la page Key concepts explique les concepts fondamentaux en termes simples : internationalization, localization, traduction, locales et context. Pour ceux qui s'appuient principalement sur des agents, la page Using agents de codage oriente les agents vers notre documentation lisible par machine, notre MCP server et notre guide AGENTS.md prêt à l'emploi (nous y reviendrons plus bas).
Concevoir une documentation lisible par les agents
Comme l'ont écrit plusieurs sources, les agents constituent désormais la majorité des lecteurs de documentation. La compatibilité avec les LLMs est donc une priorité de premier ordre. Beaucoup de principes de lisibilité et de structure valent aussi bien pour le contenu destiné aux humains qu'à celui destiné aux agents ; ces derniers ont toutefois besoin de capacités spécifiques de découverte, de récupération et d'accès aux outils.
Nous avons conçu notre compatibilité avec les agents en nous appuyant sur la spécification Agent Readability de Vercel et sur la spécification AFdocs. Ces deux spécifications répondent à des questions clés portant sur la manière dont les agents IA trouvent et analysent le contenu. Les agents peuvent-ils découvrir les pages de documentation et savoir ce qu'elles couvrent ? Peuvent-ils lire un contenu Markdown propre qui tient dans une fenêtre de contexte ? Peuvent-ils rechercher, récupérer et utiliser les bons outils IA ?
Voici les principaux éléments de notre implémentation :
llms.txt: un index de la documentation suivant le standard llmstxt.org, avec des couches supplémentaires :llms-index.txt(chaque page),llms-scope.txt/<section>(index par section) etllms-full.txt(le corpus complet, pour les outils capables de charger un contexte plus large)sitemap.xmletsitemap.md: des cartographies de toutes les pages, lisibles par machine- Du Markdown brut pour chaque page : ajoutez
.mdou.mdxà n'importe quelle URL de la documentation. Les crawlers et agents IA reconnus qui envoientAccept: text/markdownreçoivent automatiquement du Markdown - Un MCP server (Model Context Protocol) : le paquet npm
@generaltranslation/mcppour une utilisation locale en stdio, un endpoint hébergé surhttps://mcp.gtx.dev(HTTP en streaming, avec une variante SSE) et un endpoint limité à un projet surhttps://api.gtx.dev/mcp, authentifié par une clé API - Une spécification OpenAPI lisible par machine sur
/openapi.json(et/openapi.yaml), liée depuis chaque page de référence d'endpoint - Un contenu structuré en fragments pour le RAG (retrieval-augmented generation), chaque section contenant une idée complète et des hiérarchies de titres cohérentes
- Un
robots.txtpermissif : les crawlers IA ne sont jamais bloqués
Processus, maintenance et guide de style
Le déploiement de cette refonte massive de notre documentation est né d'une collaboration entre un rédacteur humain (moi-même !) et divers outils d'IA, avec les retours du reste de l'équipe. Notre principe : s'appuyer sur la rédaction et le jugement humains pour comprendre le contenu, le sens et l'enchaînement logique, traduire ces enseignements dans un guide de style strict et exhaustif, puis utiliser l'IA pour passer ce guide de style à l'échelle et rester synchronisé avec les mises à jour de notre codebase.
J'ai d'abord mené une phase de découverte approfondie afin d'établir un inventaire de tout le contenu existant de la documentation, réparti sur 900 pages et plus de 117 000 mots de prose. À partir de l'index de cette matière brute, j'ai restructuré le contenu selon une cartographie rédigée à la main : quelles sections de haut niveau étaient nécessaires, comment regrouper et ordonner les frameworks, et quel devait être l'objectif de chaque page. J'ai rédigé et édité des pages représentatives dans chaque section afin d'y intégrer nos principes de clarté, de simplicité et d'accompagnement du parcours utilisateur. La partie manuelle du processus a demandé plus d'un mois de travail concentré. Les quickstarts, en particulier, ont exigé de nombreux tests, et les ingénieurs de notre bibliothèque d'i18n y ont apporté des modifications importantes.
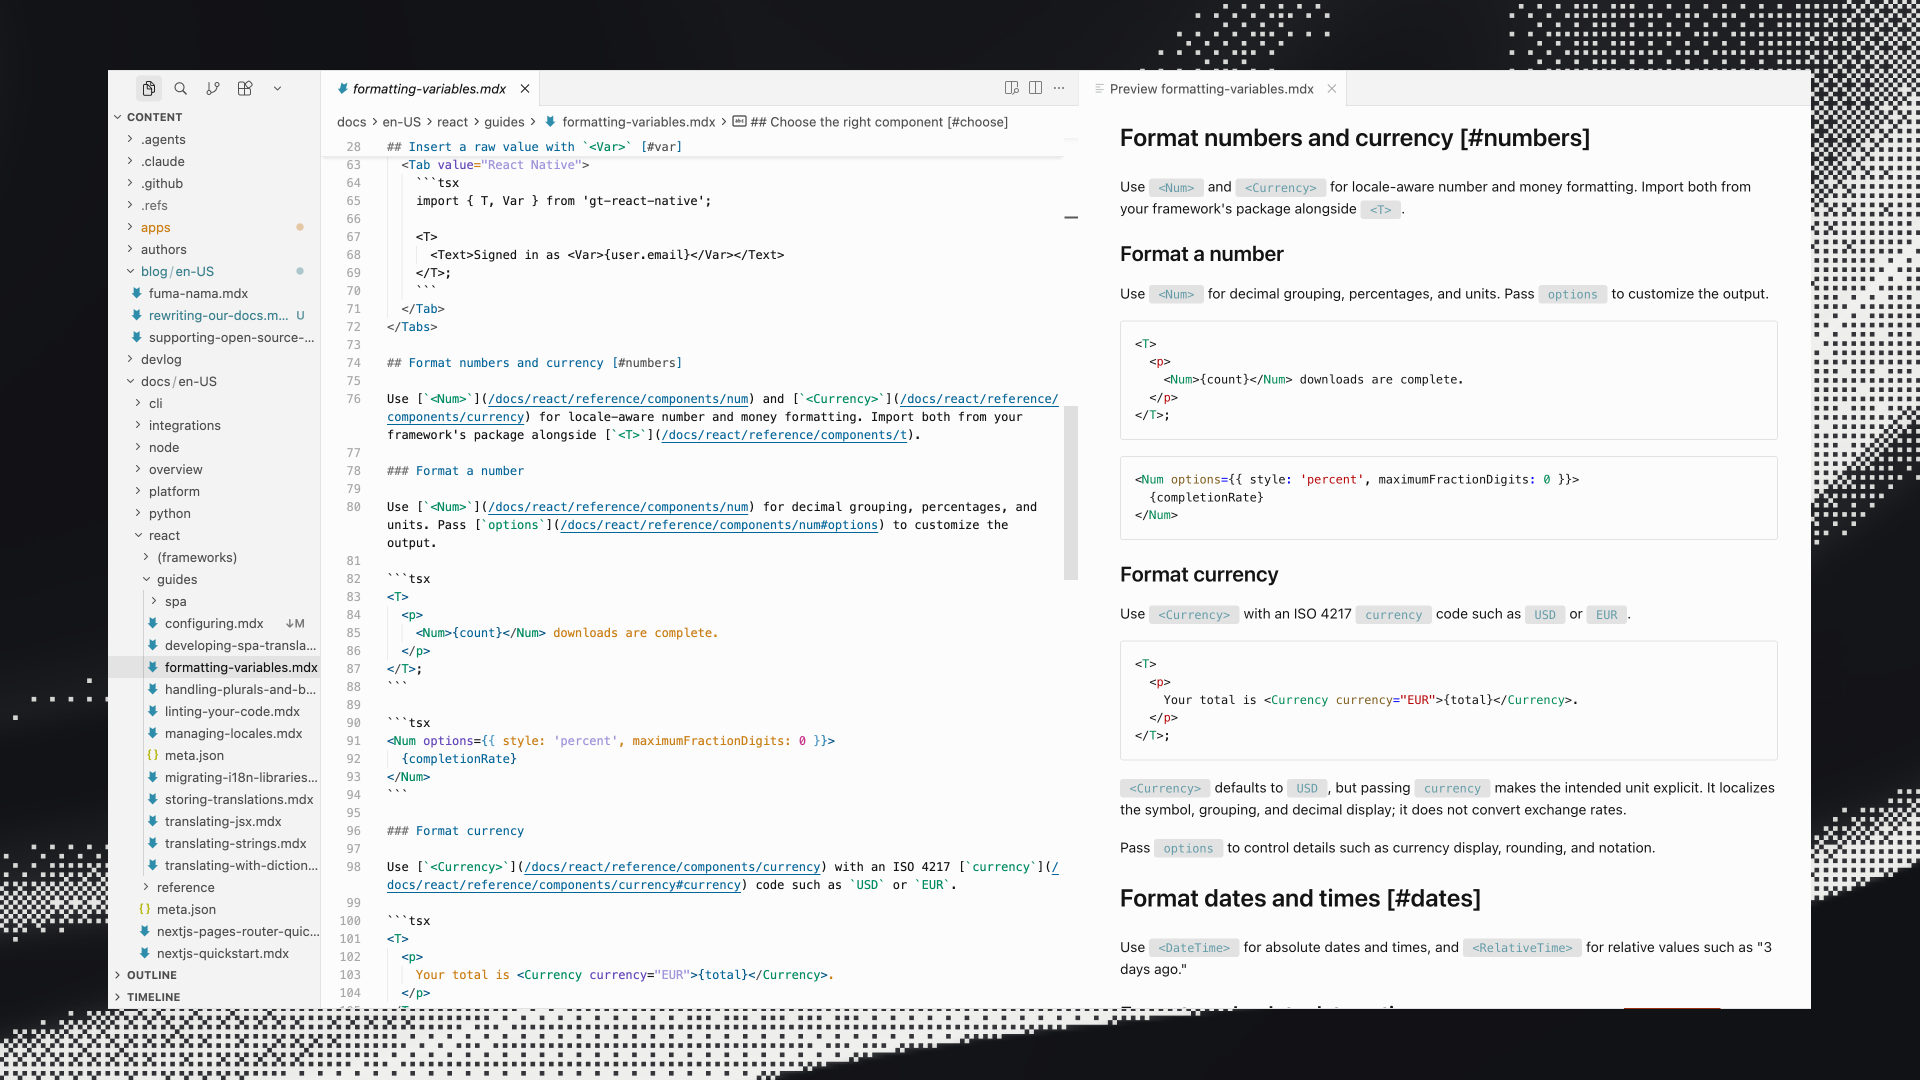
Un aspect fascinant du processus a été d'écrire directement dans Cursor, en tirant pleinement parti du volet d'aperçu Markdown. Mes modifications exactes étaient ainsi suivies dans l'historique de versions, ce qui m'a permis de demander facilement à un agent de généraliser mes changements (et même mon raisonnement) en lignes directrices et en règles, de les ajouter à notre guide de style de la documentation, et de les appliquer à toutes les pages. Chaque fois que nous modifions notre documentation, que ce soit dans sa structure ou son contenu, nous généralisons et appliquons ces changements à l'aide du guide de style.
Résultat : notre guide de style de la documentation est extrêmement détaillé et adapté à nos préférences précises en matière de documentation, couvrant une variété de cas limites et d'objectifs utilisateur, avec plus de 830 lignes et 13 000 mots. Le guide de style est un ensemble de procédures opérationnelles appliquées en CI et facilement exploitables par des agents, couvrant aussi bien des principes de rédaction généraux que des règles et des compétences très spécifiques. Un agent cloud s'exécute également chaque jour et synchronise la documentation avec le comportement effectivement livré. L'agent recherche les lacunes de couverture, les inexactitudes et les exemples obsolètes. Il crée un projet vierge et teste les fonctionnalités en local, tout en analysant la prose selon le guide de style.
Les règles du guide de style s'apparentent aux règles de contexte et de prompt personnalisé que nous appliquons pour garantir la qualité des traductions de nos clients.
Partie 2 : la conception visuelle
Nous espérons que ces changements structurels ont rendu notre documentation plus intuitive et plus simple à utiliser. Vos retours sont toujours les bienvenus. Chaque page de la documentation comporte des boutons permettant de la modifier, de signaler un problème ou de poser une question.
Ne manquez pas la partie 2 de notre blog, qui portera sur la refonte de l'UI et des interactions de notre documentation, ainsi que sur la manière dont nous avons créé des visuels personnalisés avec Fumadocs.