Taylor Fang

Diseñar para la doble experiencia de lectura
La documentación comunica un producto y su andamiaje. Debe ayudar al usuario a construir un modelo mental del producto y de su funcionamiento, guiándolo por un recorrido intuitivo y resolviendo sus dudas por el camino. La documentación debe simplificar los conceptos para quienes recién empiezan y revelar la complejidad a medida que avanzan.
Además, hay un nuevo lector. Los agentes están desplazando rápidamente a los usuarios humanos como ciudadanos de primera clase, y necesitan una arquitectura especializada para descubrir, leer e interpretar la documentación.
Nuestra documentación creció de forma orgánica a medida que nuestra plataforma se expandía para admitir nuevos frameworks e integraciones. Pero la estructura, el orden y el lenguaje empezaron a desviarse.
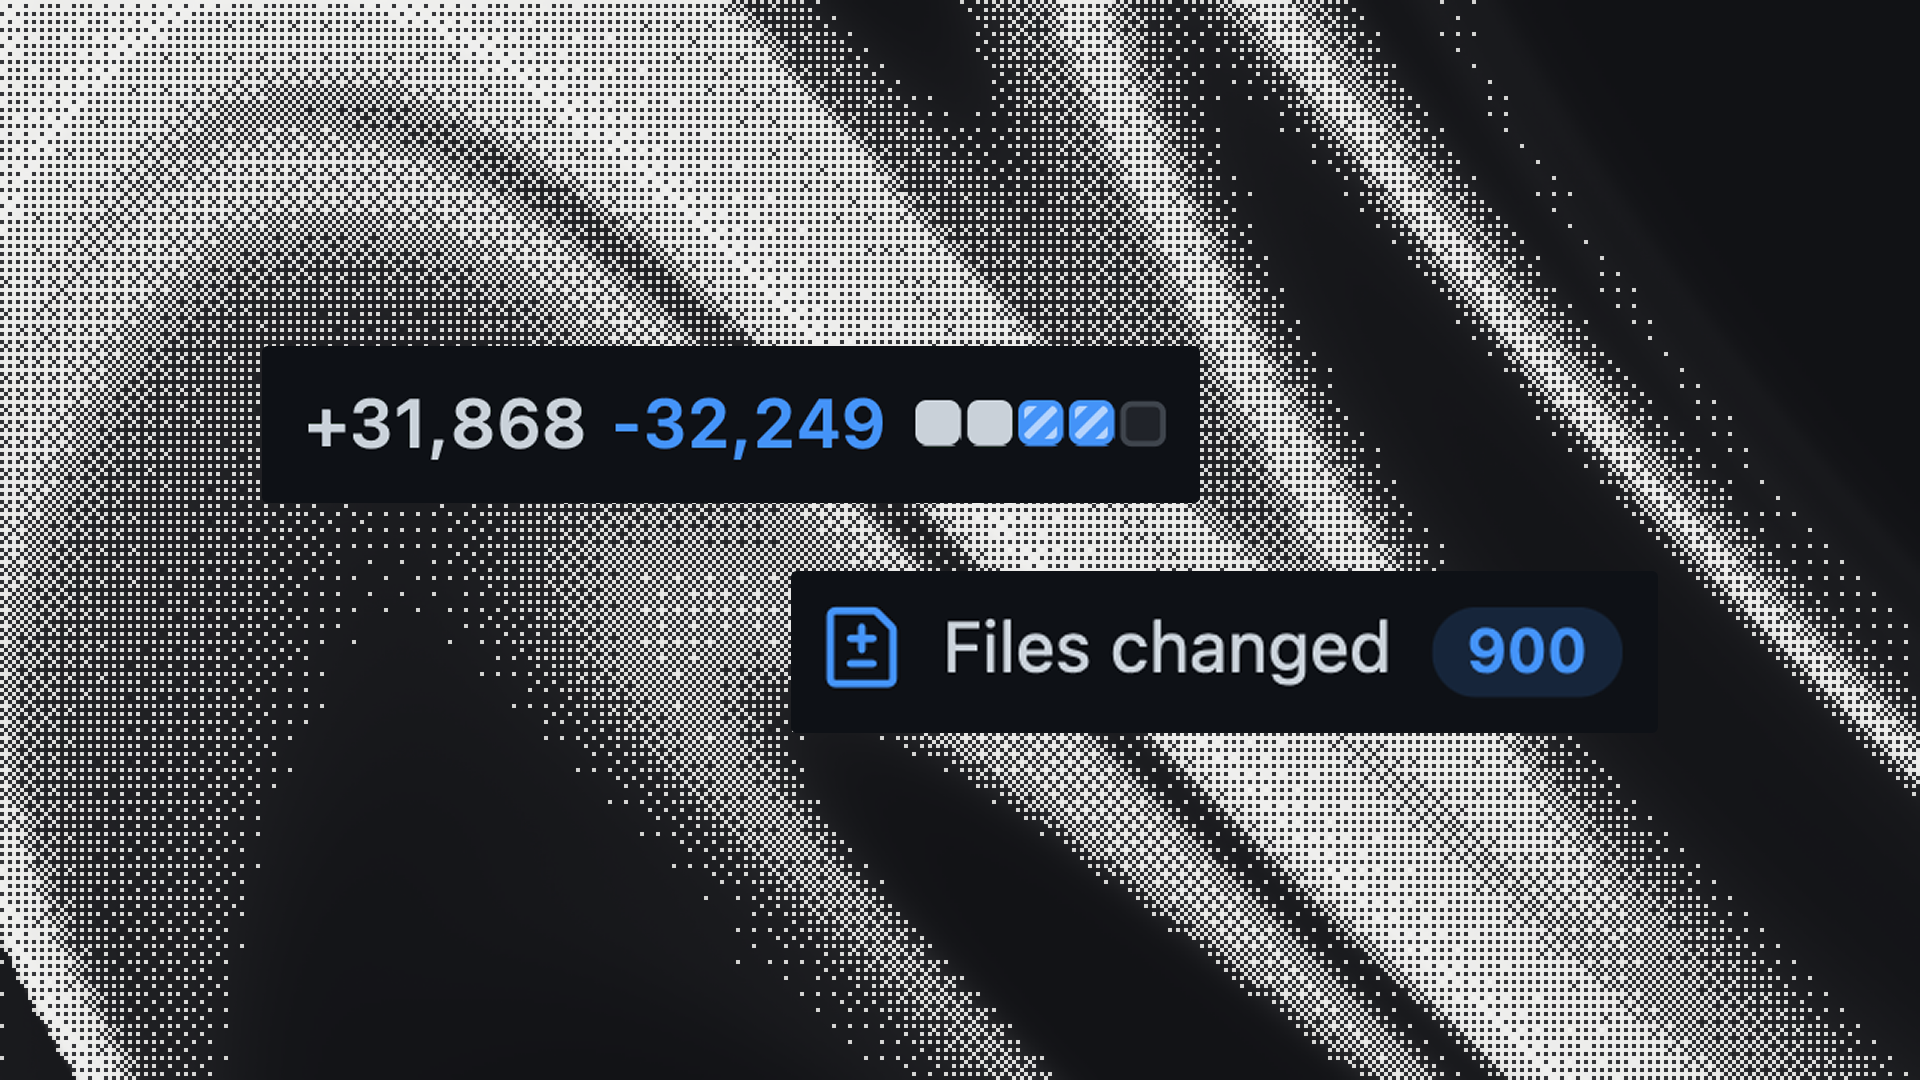
Decidimos reconstruir la documentación desde cero, con especial atención a la experiencia de lectura tanto de humanos como de agentes. La refactorización inicial afectó a 900 archivos (+31 868 / −32 249 líneas). Creamos una guía de estilo de 13 000 palabras con reglas sobre audiencia, anatomía de página, estilo y gramática. Hoy la documentación la mantiene un agente en la nube que a diario ejecuta un lint contra la guía de estilo.
Para facilitar la lectura por parte de los agentes, también servimos llms.txt y llms-full.txt para indexar el sitio, y ofrecemos cada página de la documentación como Markdown sin procesar añadiendo .md a su URL. Publicamos una página de documentación para agentes de programación con un AGENTS.md listo para usar que le indica al agente cómo configurar, utilizar y traducir correctamente, junto con nuestro MCP server y la especificación OpenAPI legible por máquinas.
Este artículo repasa los cambios que hicimos y lo que aprendimos.
Inspiraciones
Investigamos y nos inspiramos en buenas prácticas y en documentación para desarrolladores que admiramos:
- Los textos de Lee Robinson sobre documentación. «Mantén la primera experiencia simple y revela la complejidad poco a poco». Sus diez principios incluyen: rápida, legible, nativa para IA, pulida y adaptable. Y localizada, por supuesto. (¡De hecho, trabajamos con Lee para localizar la documentación de Cursor!)
- Los textos de Fuma Nama sobre documentación. Recomienda un estilo de escritura sencillo y crear una estructura más lógica con negritas, encabezados, enlaces, listas y tablas. Fuma también sostiene que la navegación puede ser más importante que el contenido para la experiencia del lector. (Lee más sobre la filosofía de Fuma en nuestra entrevista).
- Los textos de Devin Logan sobre documentación preparada para agentes. Devin escribe que el nuevo punto de partida es que los usuarios accedan a la documentación a través de agentes. Describe los pasos para lograr legibilidad para la IA: por el lado del contenido, este debe explicar sistemas y ofrecer pasos ejecutables; por el lado de la plataforma, las páginas deben ser fáciles de encontrar y estar simplificadas para los agentes.
- Analizamos de cerca la documentación para desarrolladores que nos encanta: Linear por su claridad y simplicidad, Replicate por su navegación jerárquica clara, shadcn/ui por su hermoso diseño, Next.js por su lenguaje cercano al desarrollador y sus funciones comunitarias, Convex por sus elementos visuales encantadores, Stripe por su funcionalidad incrustada, y muchas otras.
Recorridos del usuario
Reestructuramos las páginas y el lenguaje en torno a lo que el usuario quiere lograr, en lugar de limitarnos a describir capacidades técnicas. Cada sección sigue una misma columna vertebral: Quickstart, Guías y Referencia.
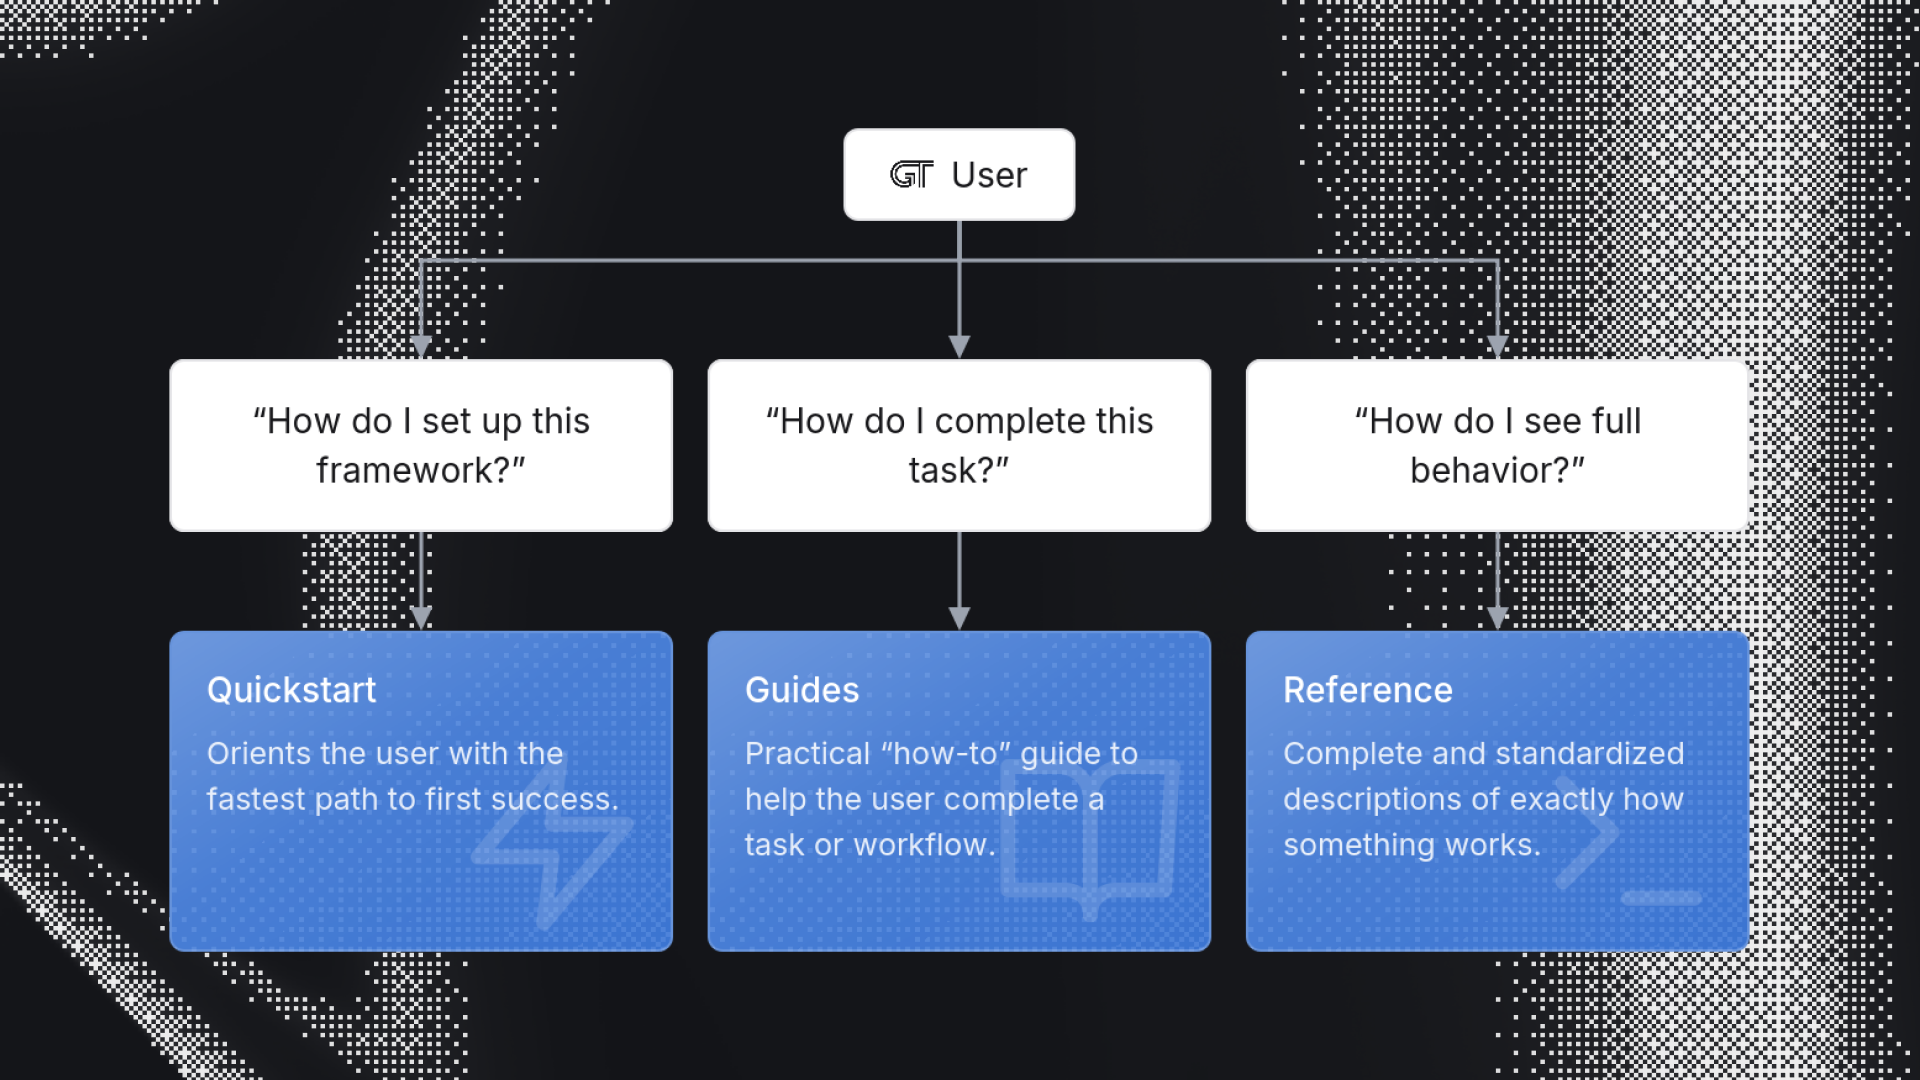
Las guías se titulan con gerundios y con tareas por realizar, como «Revisión y edición de traducciones» o «Manejo de plurales y branches». Un usuario nuevo que intenta completar un workflow no necesita averiguar qué término de referencia buscar; basta con buscar la acción que quiere realizar.
Un grato efecto secundario es que nuestras propias guías de documentación se posicionan muy bien en SEO, incluso como primer resultado de Google para búsquedas como «React managing locales», «React translating jsx», «Configuring a Vite SPA i18n», «React plurals and branches», «Translating rrweb» y muchas otras.
El sitio de documentación está construido sobre Fumadocs, cuyo creador entrevistamos hace poco acerca de su filosofía de una experiencia de lectura bella y composable.
Flujo lógico e intuitivo
La documentación debe ayudar al usuario a formarse un modelo mental del producto y de su funcionamiento. Por eso es importante que el flujo sea intuitivo tanto en la navegación como dentro de cada página. El orden debe ser deliberado y significativo, agrupado de forma lógica y secuenciado según el orden en que es probable que el lector realice una acción. La idea es acompañar la curva de aprendizaje, para que quienes empiezan puedan construir fácilmente el contexto correcto, y la complejidad y la personalización se vayan revelando a medida que leen y profundizan. Un flujo intuitivo debería pasar desapercibido.
a) Estructura. La estructura y el orden de nuestra documentación se aplican en CI, mediante una verificación que fija las secciones de nivel superior para que cada página nueva encaje en la arquitectura de información existente.
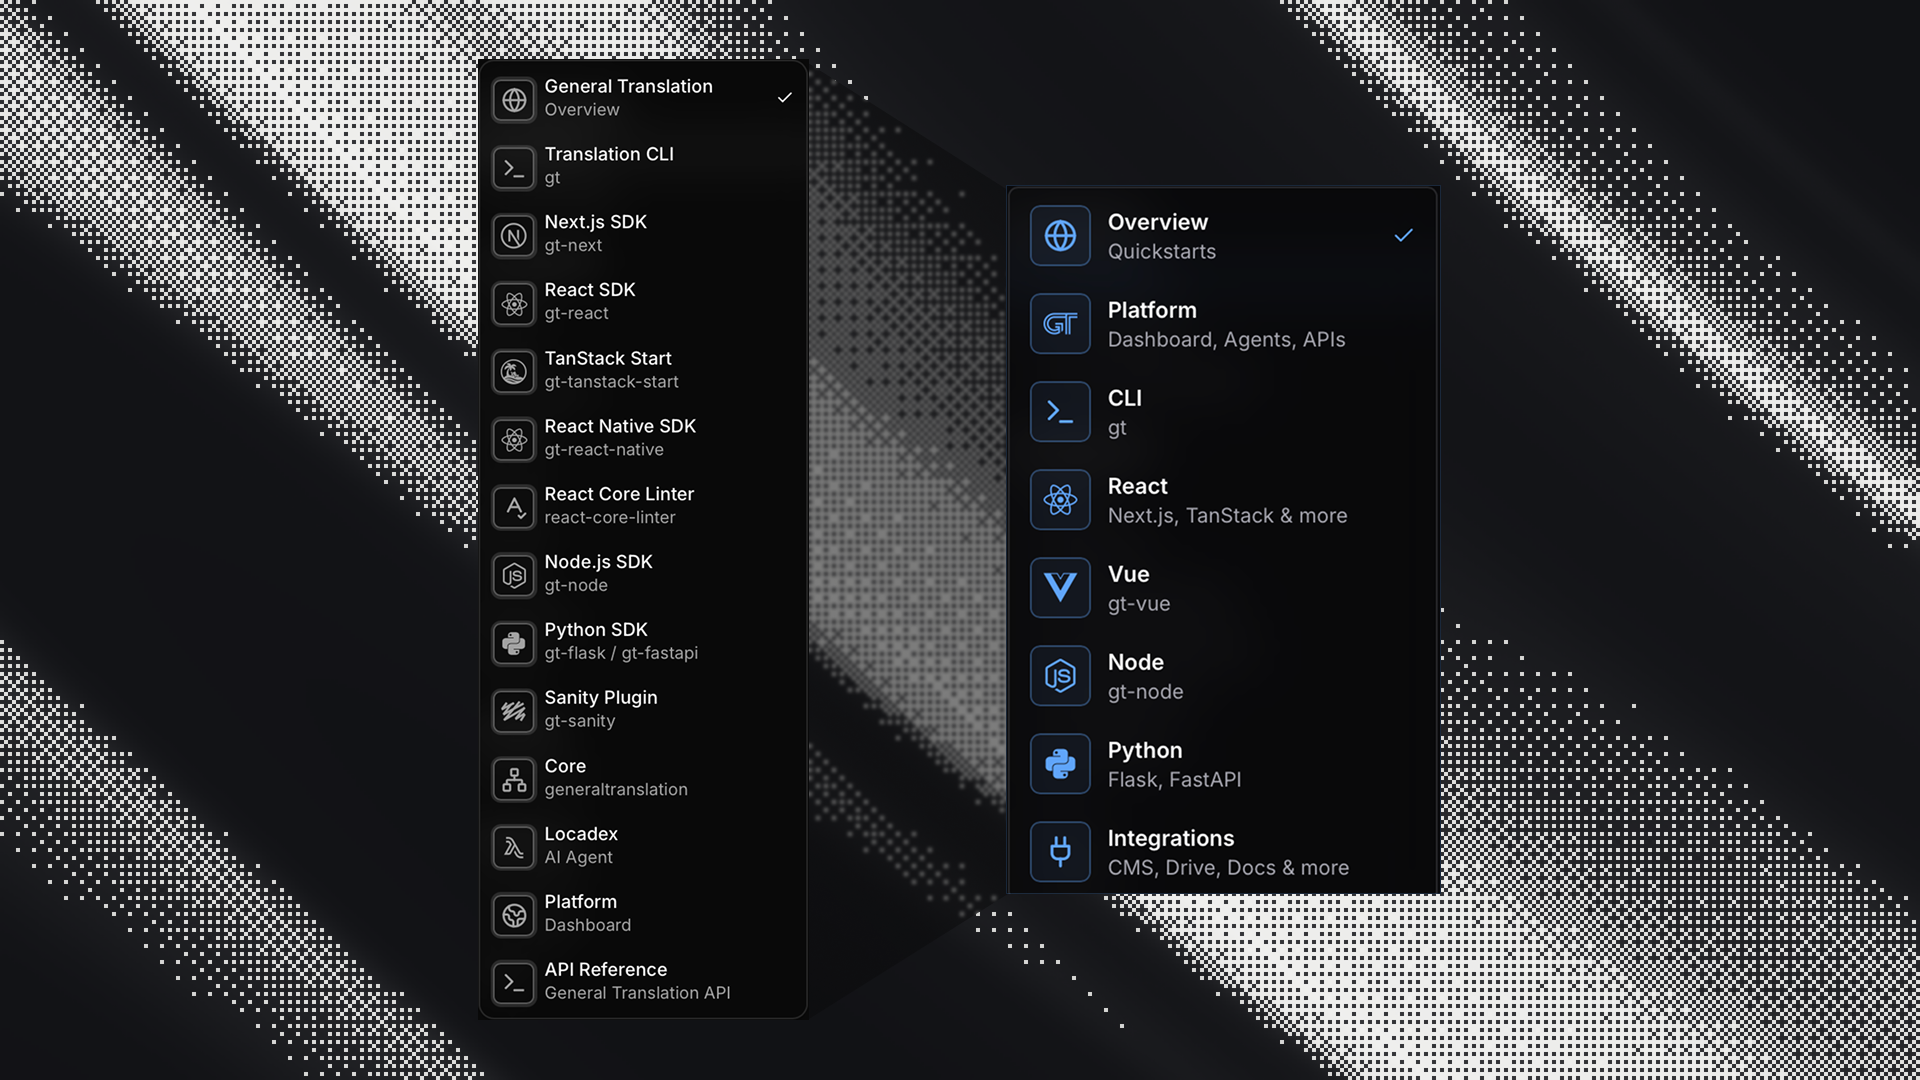
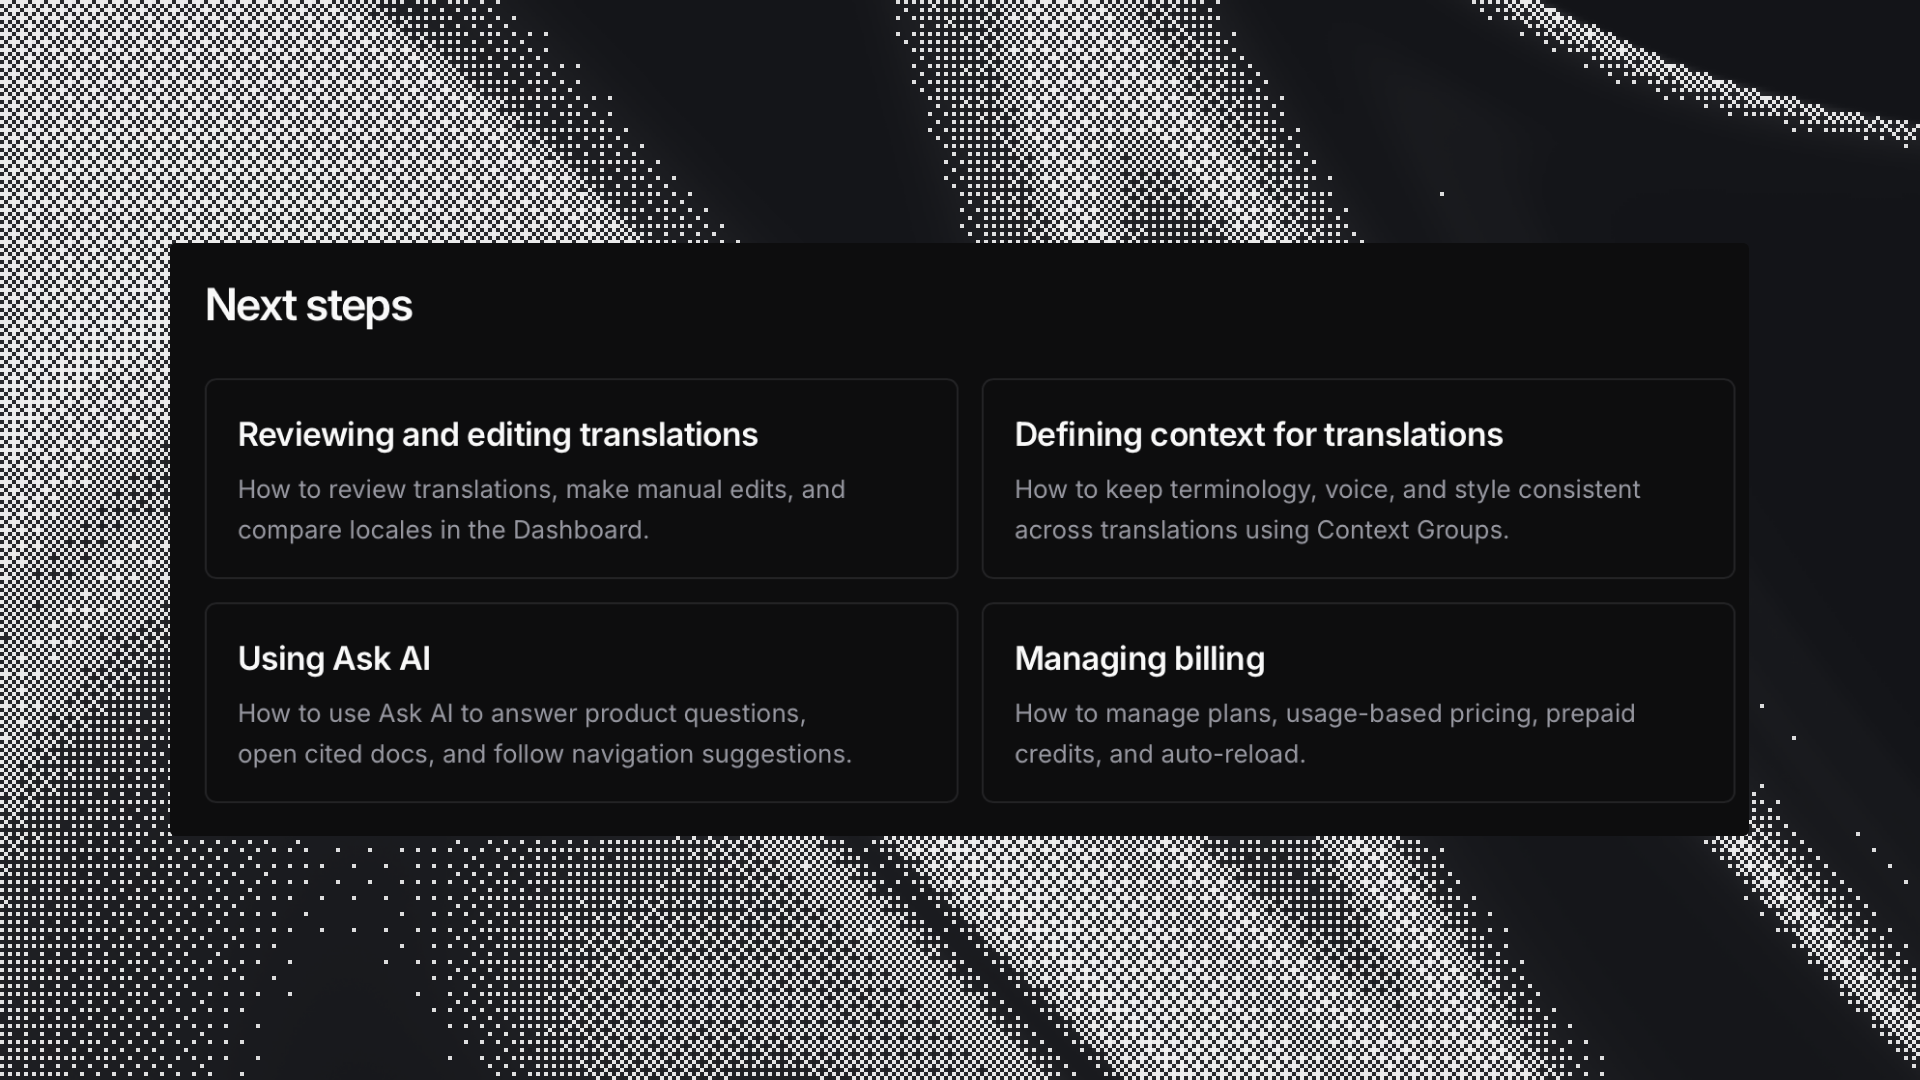
b) Páginas relacionadas. Cada página guía a los usuarios hacia los siguientes pasos, con enlaces relacionados actualizados por proximidad lógica. Quickstart lleva a las cuatro páginas de guías más consultadas, y cada página de guías lleva a guías o referencia relacionadas. Los enlaces están en el frontmatter y no en el cuerpo del texto, de modo que la compilación puede verificar los destinos contra el árbol de páginas.
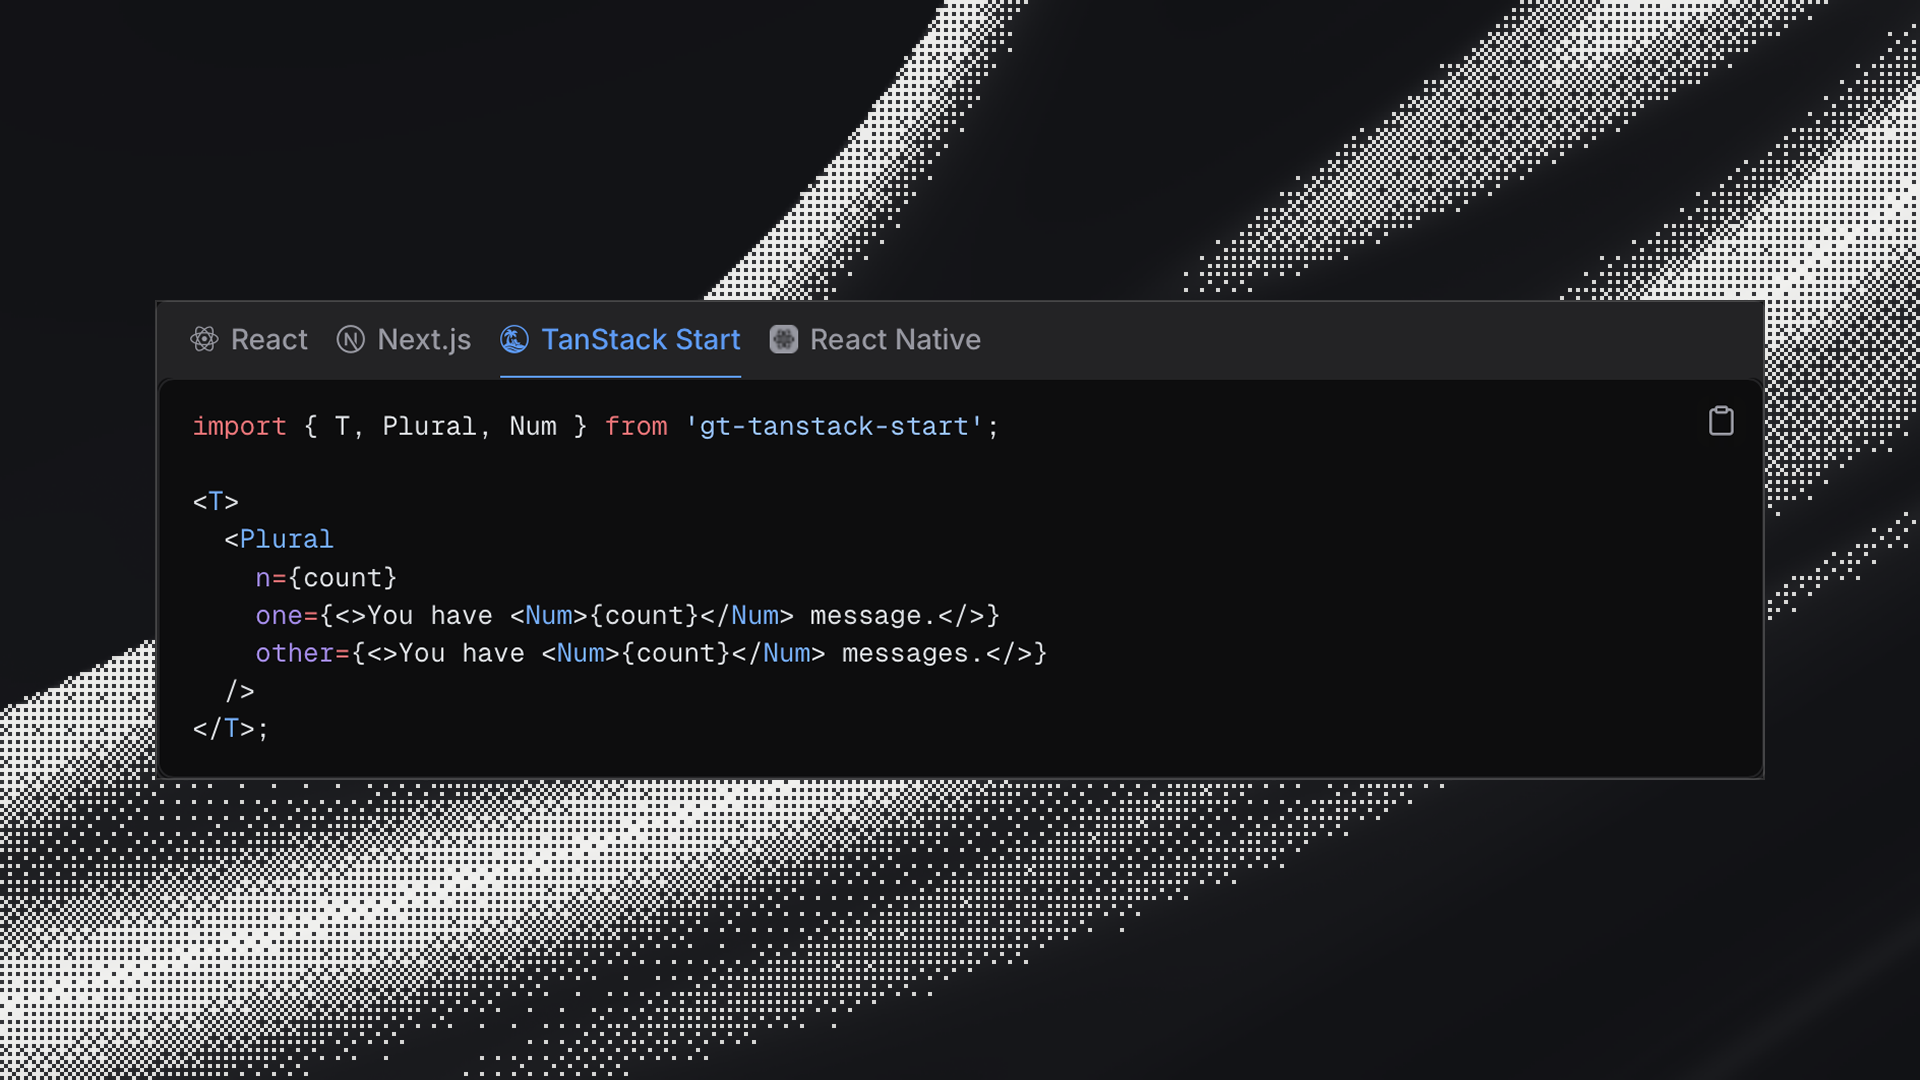
c) Selecciones del usuario. El sitio de documentación recuerda las selecciones del usuario y muestra el contenido automáticamente en el idioma y el tema elegidos por última vez. Los code blocks también conservan automáticamente la pestaña seleccionada por el usuario para el framework (React, Next.js, TanStack Start o React Native) y el administrador de paquetes (npm, yarn, bun o pnpm).
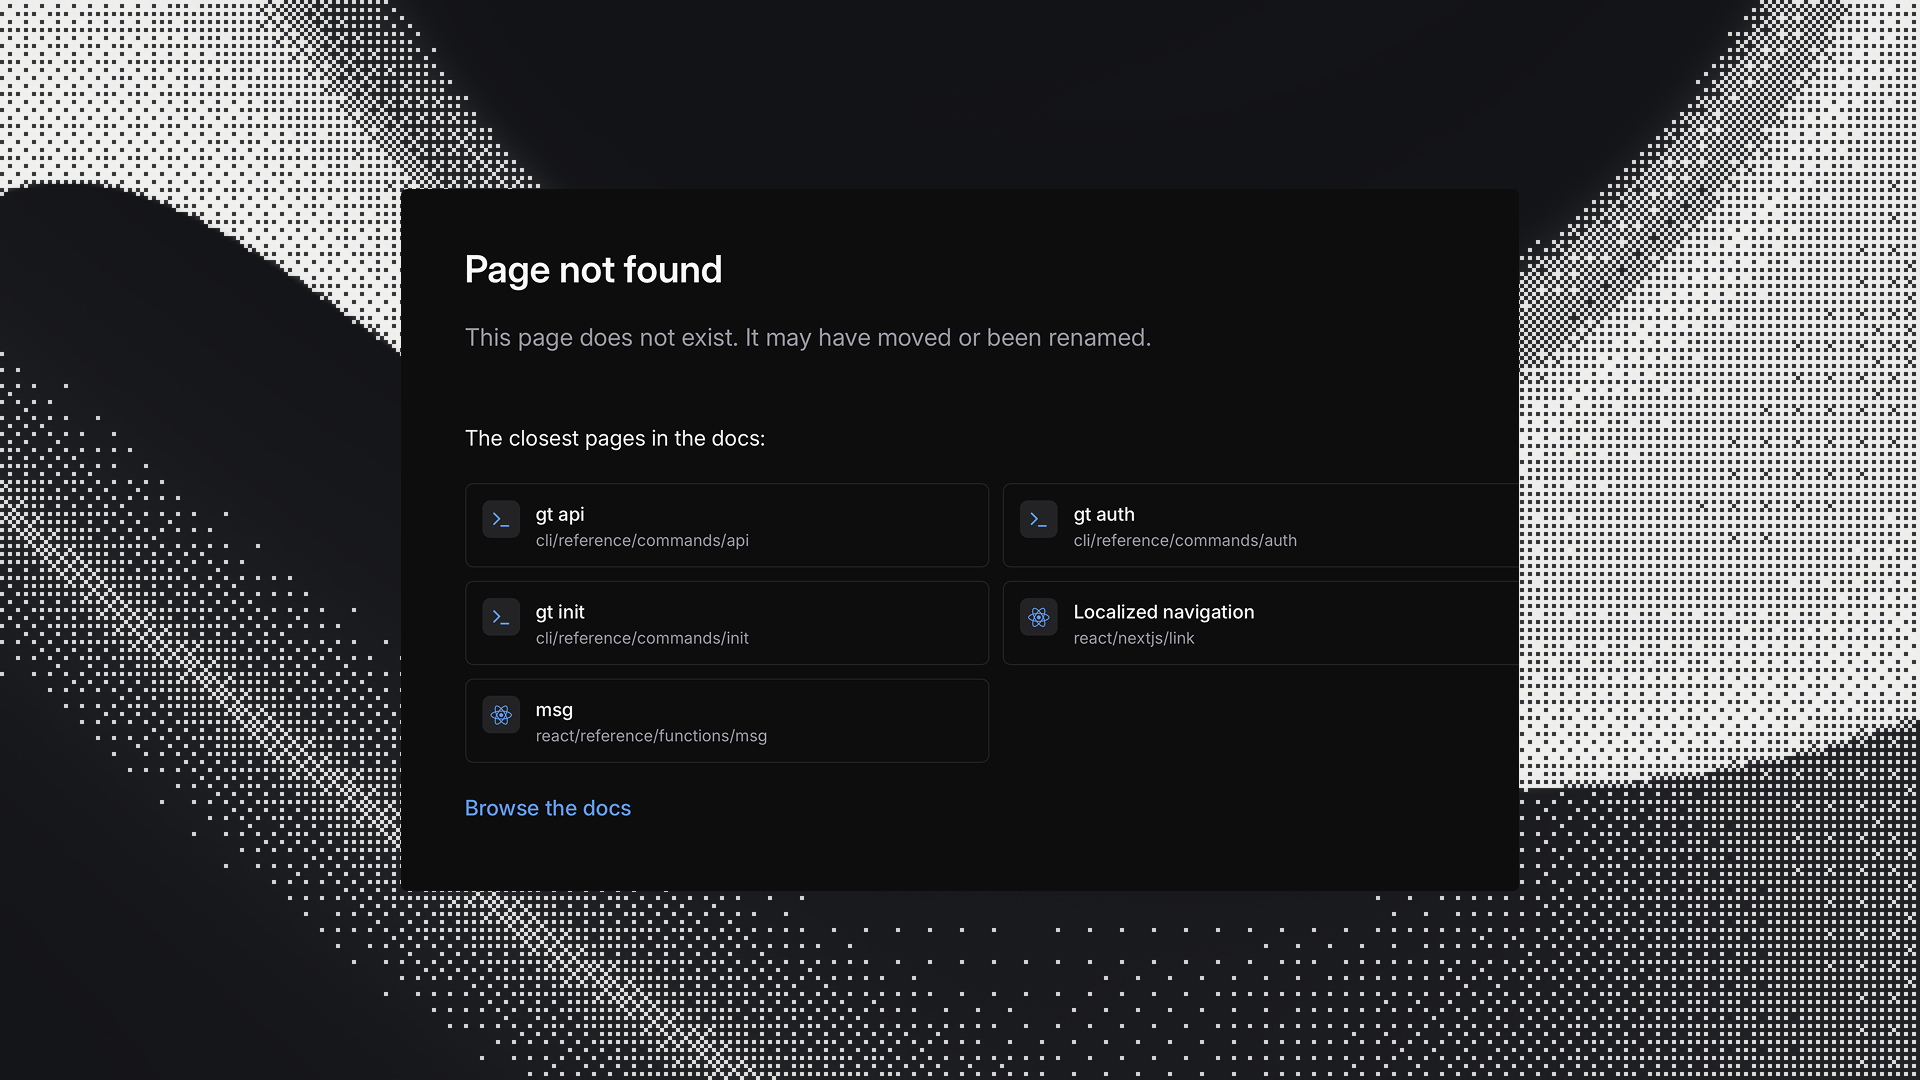
d) Rutas de enlace. Nuestras rutas de enlace son otro pequeño detalle: los slugs no son simplemente el título de la página, sino la menor cantidad de palabras que siguen siendo inequívocas. Los enlaces y los anclajes de los headings se mantienen iguales aunque cambie la redacción o el contenido. También hemos incorporado un sistema que detecta URL mal escritas para redirigir a la coincidencia más cercana o a un 404 especial con las cinco páginas más parecidas.
Lenguaje sencillo
Dada la gran variedad de perfiles de usuario en nuestra plataforma, el lenguaje en sí se centra en la simplicidad y la claridad. Cada página orienta primero al lector sobre qué cubre y cuándo usarla, antes de entrar en cómo funciona. Cada sección es además un bloque enfocado y autocontenido, algo que, según hemos comprobado, resulta más fácil de leer tanto para personas como para agentes.
Cada página se dirige a un público específico y está adaptada a él. De nuestra guía de estilo de documentación:
Público
Escribe para el lector de esa página concreta y ajusta la profundidad y el vocabulario a su perfil:
- Páginas técnicas, orientadas a desarrolladores. Los lectores son desarrolladores que integran el SDK, la CLI o la API. Sé preciso con los tipos, los parameters, las cabeceras, los valores predeterminados y el comportamiento ante errores; muestra ejemplos ejecutables. Asegúrate de que la documentación también sea legible por máquinas para LLMs y agentes.
- Páginas no técnicas, orientadas al producto: Dashboard y Locadex. Los lectores son responsables de localization, traductores y responsables de producto que trabajan en la interfaz de usuario del panel de control. Empieza por los resultados y las acciones en la interfaz de usuario; explica los conceptos en lenguaje llano.
Reglas de claridad para todos los públicos:
Empieza por qué es y por qué, antes del cómo.
Una idea por frase; prioriza las frases cortas.
Define un término la primera vez que aparece y desarrolla las siglas en su primer uso.
No uses un concepto, término de producto o ajuste antes de haberlo presentado.
Evita la jerga sin explicar. Si un término es inevitable y demasiado complejo para explicarlo en una frase, enlaza al lugar donde se define.
También escribimos páginas para perfiles de usuario concretos. Para quienes se inician en la localization, la página Key concepts explica los conceptos fundamentales en lenguaje básico: internationalization, localization, traducción, locales y contexto. Para quienes trabajan principalmente con agentes, la página Using coding agents dirige a los agentes hacia nuestra documentación legible por máquinas, el MCP server y la guía AGENTS.md lista para usar (más sobre esto a continuación).
Diseñar para que lo lean los agentes
Como han señalado múltiples fuentes, hoy los agentes constituyen la mayoría de los lectores de la documentación. Por eso, la compatibilidad con LLMs es una prioridad de primer orden. Muchos de los principios de legibilidad y estructura valen tanto para el contenido dirigido a personas como para el dirigido a agentes; sin embargo, los agentes necesitan capacidades especializadas de descubrimiento, recuperación y acceso a herramientas.
Hemos diseñado nuestra preparación para agentes siguiendo la especificación Agent Readability de Vercel y la especificación AFdocs. Estas dos especificaciones abordan preguntas clave sobre cómo los AI agentes encuentran y analizan el contenido. ¿Pueden los agentes descubrir las páginas de la documentación y orientarse sobre lo que cubren? ¿Pueden leer contenido en Markdown limpio que quepa en una ventana de contexto? ¿Pueden buscar, obtener y usar las herramientas de IA correctas?
Estas son algunas partes clave de nuestra implementación:
llms.txt: un índice de la documentación que sigue el estándar llmstxt.org, con capas adicionales:llms-index.txt(todas las páginas),llms-scope.txt/<section>(índices por sección) yllms-full.txt(el corpus completo, para herramientas capaces de cargar un contexto más grande)sitemap.xmlysitemap.md: mapas legibles por máquinas de todas las páginas- Markdown en crudo para cada página: añade
.mdo.mdxa cualquier URL de la documentación. Los rastreadores y agentes de IA reconocidos que envíanAccept: text/markdownreciben Markdown automáticamente - Un servidor MCP (Model Context Protocol): el paquete de npm
@generaltranslation/mcppara uso local mediante stdio, un endpoint alojado enhttps://mcp.gtx.dev(streamable HTTP, con una variante SSE) y un endpoint con alcance de Project enhttps://api.gtx.dev/mcpautenticado con una API Key - Una especificación OpenAPI legible por máquinas en
/openapi.json(y/openapi.yaml), enlazada desde cada página de referencia de endpoints - Contenido estructurado en fragmentos para RAG (generación aumentada por recuperación), donde cada sección contiene una idea completa y jerarquías de headings coherentes
- Un
robots.txtpermisivo: los rastreadores de IA nunca se bloquean
Proceso, mantenimiento y guía de estilo
El proceso de desplegar esta refactorización masiva de nuestra documentación fue una colaboración entre un redactor humano (¡yo!) y diversas herramientas de IA, con aportes del resto del equipo. Nuestro principio es usar la redacción y el criterio humanos para aportar comprensión del contenido, el significado y el flujo lógico, trasladar los aprendizajes a una guía de estilo estricta y exhaustiva, y usar la IA para escalar esa guía de estilo y mantenernos sincronizados con las actualizaciones de nuestro codebase.
Primero hice una revisión exhaustiva de descubrimiento para obtener un inventario de todo el contenido existente de la documentación, repartido en 900 páginas y más de 117.000 palabras de prosa. Con el índice de ese material en bruto, reestructuré el contenido siguiendo un mapa escrito a mano: qué secciones de alto nivel necesitábamos, cómo debían agruparse y ordenarse los frameworks, y cuál era el propósito de cada página. Escribí y edité páginas representativas de cada sección para incorporar nuestros principios de claridad, simplicidad y acompañamiento del recorrido del usuario. La parte manual del proceso llevó más de un mes de trabajo concentrado. Los quickstarts, en particular, requirieron muchas pruebas, y los ingenieros de nuestra i18n library hicieron ediciones significativas.
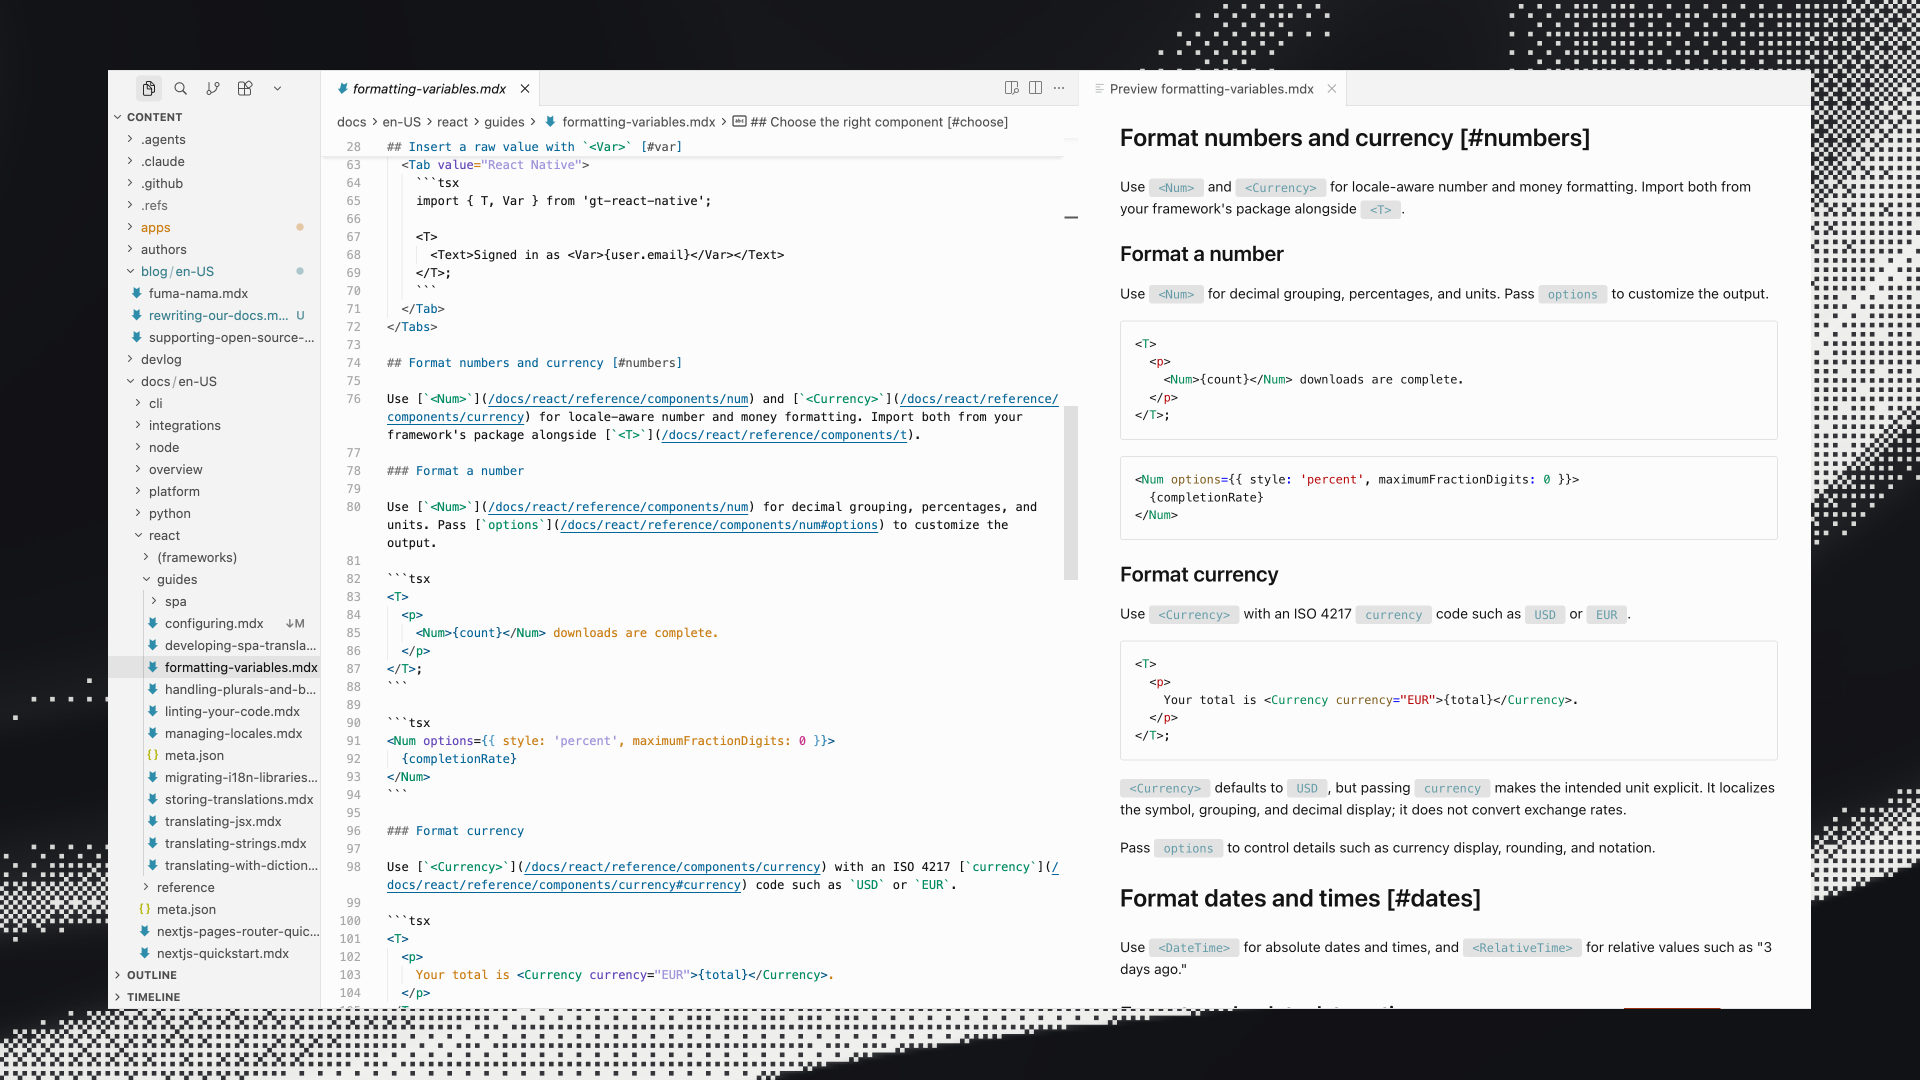
Una parte fascinante del proceso fue escribir directamente en Cursor, aprovechando bien el panel de vista previa de Markdown. Esto significaba que mis cambios exactos quedaban registrados en el historial de versiones, así que después podía pedirle fácilmente a un agente que generalizara mis cambios (e incluso mi razonamiento) en directrices y reglas, los añadiera a nuestra guía de estilo de documentación y los aplicara en todas las páginas. Cada vez que editamos nuestra documentación, ya sea en estructura o en contenido, generalizamos y aplicamos esos cambios mediante la guía de estilo.
Gracias a este proceso, nuestra guía de estilo de documentación es extremadamente detallada y específica para nuestras preferencias exactas de documentación, y cubre una gran variedad de casos límite y objetivos de usuario, con más de 830 líneas y 13.000 palabras. La guía de estilo es un conjunto de procedimientos operativos que se aplican en CI y que los agentes pueden poner en práctica con facilidad, y abarca tanto principios generales de redacción como reglas y habilidades muy concretas. Además, un agente en la nube se ejecuta a diario y sincroniza la documentación con el comportamiento ya publicado. El agente busca lagunas de cobertura, imprecisiones y ejemplos desactualizados. Levanta un proyecto nuevo y prueba las funcionalidades en local, y también analiza la prosa con lint según la guía de estilo.
Las reglas de la guía de estilo son similares a las reglas de contexto e indicaciones personalizadas que aplicamos para garantizar la calidad de las traducciones de nuestros clientes.
Parte 2: diseño visual
Esperamos que estos cambios estructurales hayan hecho que nuestra documentación sea más intuitiva y fácil de usar. Siempre nos encanta recibir tus comentarios. Cada página de la documentación cuenta con botones para editarla, reportar un problema o hacer una pregunta.
No te pierdas la parte 2 de nuestro blog, en la que hablaremos del rediseño de la interfaz de usuario y de la interacción en nuestra documentación, y de cómo creamos elementos visuales personalizados con Fumadocs.